Wie lange dauert ein DDoS-Angriff? Zwei echte Fälle aus dem Betrieb
Die meisten DDoS-Angriffe sind nach Minuten vorbei, manche laufen stundenlang. Dieser Artikel zeigt beide Fälle an echten Messdaten: einen Angriff mit 745,5 Gbit/s und 73,1 Millionen Paketen pro Sekunde, der nach acht Minuten endete, und einen mit 501,2 Gbit/s, der drei Stunden und 31 Minuten durchlief. Dazu, wie ein Angriffsalarm Feld für Feld zu lesen ist, warum die Paketrate oft wichtiger ist als die Bandbreite und warum Portwechsel und Adresswechsel in beiden Fällen nichts gebracht hätten.
Die Frage kommt fast immer in den ersten Minuten eines Angriffs, und sie kommt meistens in dieser Form: Wie lange geht das noch? Die ehrliche Antwort lautet, dass die Dauer nicht vom Angegriffenen abhängt, sondern von dem, der bezahlt hat. Der weitaus größte Teil aller Angriffe ist nach wenigen Minuten vorbei. Ein kleinerer, aber keineswegs seltener Teil läuft über Stunden. Für die Abwehr sind das zwei vollkommen verschiedene Aufgaben.
Dieser Artikel zeigt beide Fälle an echten Messdaten aus dem Betrieb von KernelHost: einen Angriff, der nach acht Minuten vorbei war und dabei 745,5 Gbit/s erreichte, und einen, der drei Stunden und 31 Minuten durchlief und dabei auf 501,2 Gbit/s kam. Beide wurden vollständig gefiltert, beide ohne Ausfall, beide ohne Nullrouting. Die Abbildungen stammen unverändert aus dem Live-Monitoring der Abwehr, lediglich das letzte Oktett der Zieladresse ist entfernt.
Die kurze Antwort
Ein typischer DDoS-Angriff dauert Minuten, nicht Stunden. Das liegt daran, dass die überwiegende Mehrheit der Angriffe über gemietete Dienste läuft, die in Zeitfenstern verkauft werden, und das billigste Fenster ist bei fast allen Anbietern das kürzeste. Wer einen Angriff gegen einen Gameserver bestellt, kauft in der Regel 60, 300 oder 600 Sekunden.
Das erklärt die Form der Verteilung: eine sehr hohe Spitze bei wenigen Minuten und ein langer, dünner Ausläufer, der bis in den Bereich von Stunden und in Einzelfällen bis über einen Tag reicht. Der Ausläufer ist der teure Teil. Er kommt zustande, wenn jemand ein Abonnement hat, wenn mehrere Besteller sich an dasselbe Ziel hängen, oder wenn der Angriff automatisch neu gestartet wird, sobald er endet.
Für Sie als Betroffenen bedeutet das zweierlei. Erstens: Abwarten ist statistisch gesehen oft richtig, aber es ist keine Strategie, weil Sie vorher nicht wissen, in welchem Teil der Verteilung Sie gelandet sind. Zweitens: Eine Abwehr, die kurze Spitzen abfängt, aber bei Dauerbeschuss nachgibt, löst nur die halbe Aufgabe.
Zwei echte Angriffe aus unserem Netz
Die folgenden zwei Alarme liegen zehn Tage auseinander und treffen unterschiedliche Kunden. Sie sind deshalb interessant, weil sie fast die gegenteiligen Eigenschaften haben: Der eine ist extrem kurz und extrem hart, der andere ist deutlich schwächer und dafür ausdauernd. Beide gehören in die Kategorie, die das Monitoring als Fast Flood kennzeichnet, also als Angriff, der die Alarmschwelle nicht langsam überschreitet, sondern in sehr kurzer Zeit.
Fall 1: acht Minuten, 745,5 Gbit/s, 73,1 Millionen Pakete pro Sekunde
Am 28. September 2026 um 14:34 Uhr begann ein UDP-Flood gegen einen Dienst eines Kunden. Um 14:43 Uhr war der Alarm geschlossen, die Gesamtdauer betrug acht Minuten. Der eigentliche Beschuss war noch kürzer: Die Kurve steigt zwischen 14:34 und 14:35 an, hält etwa zwei Minuten und fällt zwischen 14:36 und 14:37 wieder auf null.
In dieser kurzen Zeit erreichte der Angriff an der Grenze des überwachten Objekts 745,5 Gbit/s und 73,1 Millionen Pakete pro Sekunde. Zur Einordnung: Eine Leitung mit 1 Gbit/s trägt bei kleinsten Ethernet-Rahmen etwa 1,49 Millionen Pakete pro Sekunde. Der Angriff lag damit bei etwa der 49-fachen Paketrate und bei der 745-fachen Bandbreite eines solchen Anschlusses.
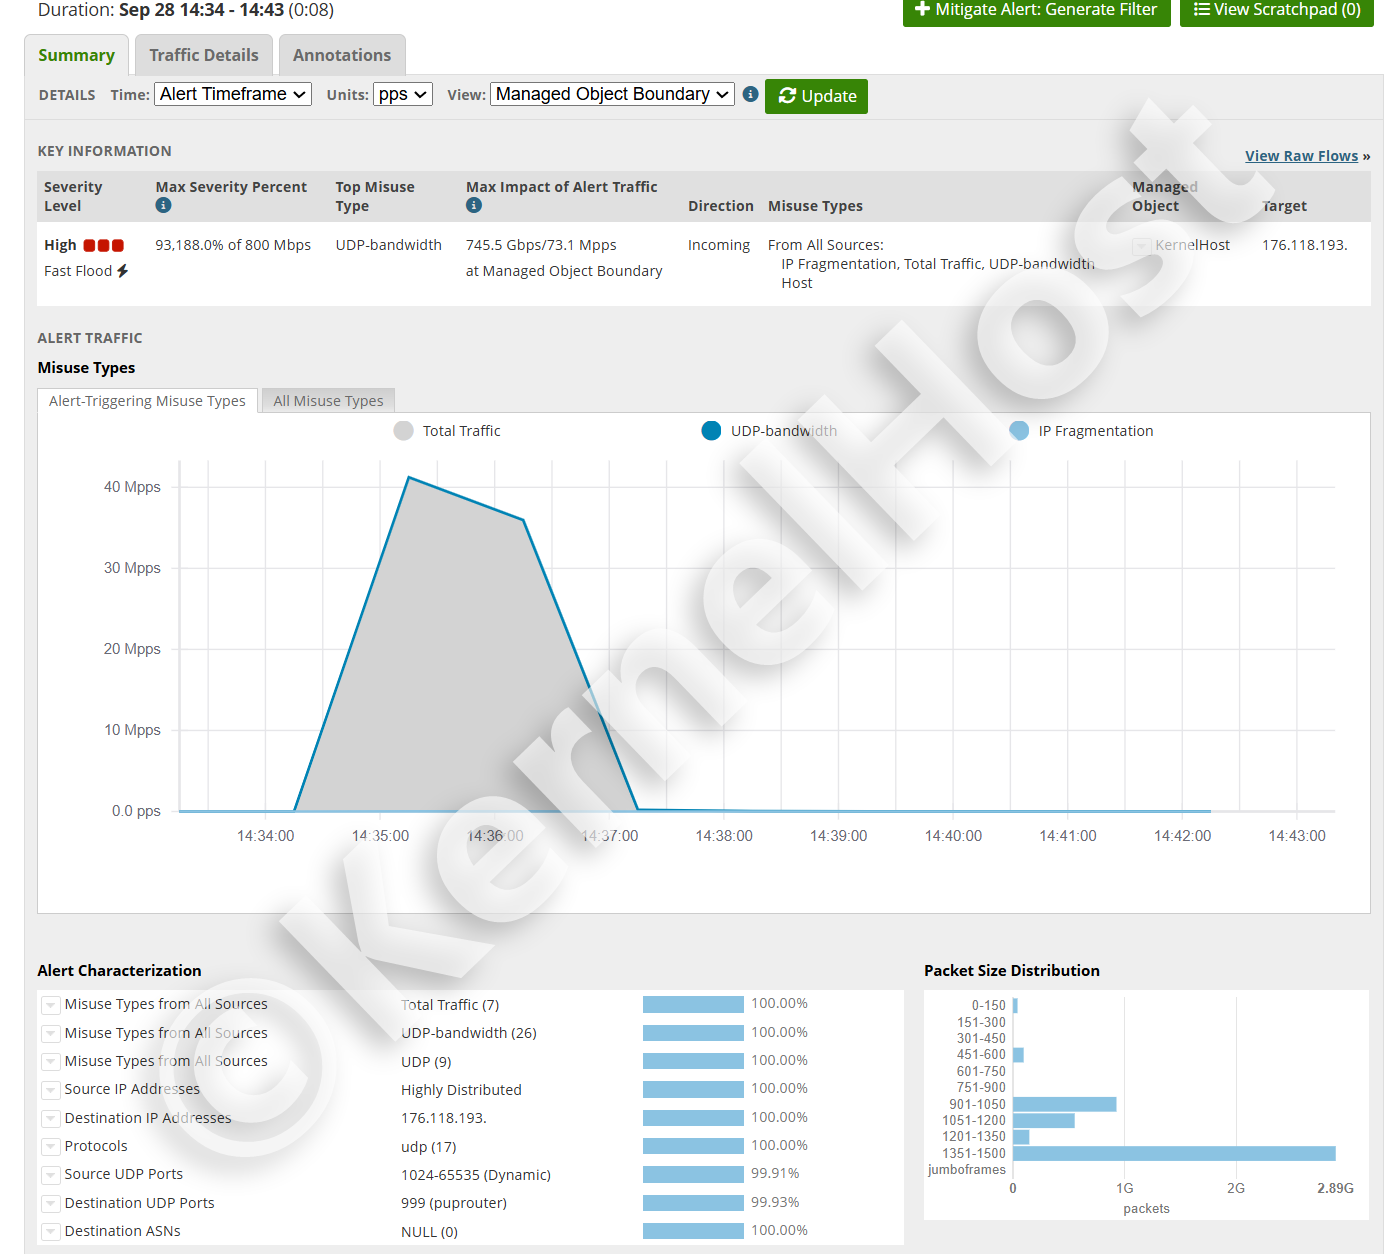
Der Dienst blieb während des gesamten Angriffs erreichbar. Es gab keine Umschaltung, keinen Wechsel auf eine andere Adresse und keine Null Route. Die Filterung lief von der ersten Sekunde an mit, weil sie bei jedem Serverpaket dauerhaft aktiv ist und nicht erst bei einem Alarm zugeschaltet wird.
Was in diesem Alarm steht, Feld für Feld
Der Alarm ist nicht nur ein Bild, er ist eine Messung. Die Felder lassen sich gegeneinander prüfen, und genau das macht sie belastbar.
Max Severity Percent: 93.188,0 Prozent von 800 Mbit/s. Die Alarmschwelle für dieses überwachte Objekt liegt bei 800 Mbit/s. Der Angriff erreichte das 931,88-fache dieser Schwelle. Rechnen Sie nach: 931,88 mal 0,8 Gbit/s ergibt 745,5 Gbit/s. Das ist exakt der Wert im Feld daneben. Die beiden Zahlen stammen aus derselben Messung und bestätigen sich gegenseitig.
Top Misuse Type: UDP-bandwidth. Das Hauptmuster war schiere UDP-Bandbreite, kein Protokollangriff und kein Anwendungsangriff. Daneben erkannte das Monitoring IP Fragmentation und Total Traffic als weitere ausgelöste Muster.
Source IP Addresses: Highly Distributed, 100 Prozent. Es gab keine dominierende Quelle und keine kleine Gruppe von Quellen. Der Verkehr kam von sehr vielen Adressen gleichzeitig. Das ist der Grund, warum eine Sperrliste in solchen Fällen nichts bringt: Es gibt nichts, was sich sinnvoll auf eine Liste setzen ließe.
Protocols: udp (17), 100 Prozent. Ausschließlich UDP. Kein TCP, kein ICMP.
Source UDP Ports: 1024 bis 65535 (Dynamic), 99,91 Prozent. Die Quellports waren zufällig. Das schließt eine Reflexion über einen festen Dienstport als Hauptvektor praktisch aus und spricht für direkt erzeugten Verkehr aus einem Botnetz.
Destination UDP Ports: 999, 99,93 Prozent. Fast der gesamte Verkehr ging auf einen einzigen Zielport. Dieser Angriff war auf einen konkreten Dienst gerichtet, nicht auf den Server allgemein.
Packet Size Distribution: Schwerpunkt bei 1351 bis 1500 Byte, rund 2,89 Milliarden Pakete. Das sind große Pakete, nahe an der üblichen MTU von 1500 Byte. Allein in dieser Größenklasse liefen damit zwischen 3,9 und 4,3 Terabyte auf, in wenigen Minuten.
Auch diese Zahl lässt sich gegenprüfen: 745,5 Gbit/s geteilt durch 73,1 Millionen Pakete pro Sekunde ergeben eine mittlere Paketgröße von rund 1275 Byte. Das passt zu einer Verteilung, deren Schwerpunkt bei 1351 bis 1500 Byte liegt und die nach unten einige kleinere Klassen mitnimmt.
Fall 2: drei Stunden und 31 Minuten, 501,2 Gbit/s, 43,9 Millionen Pakete pro Sekunde
Am 18. September 2026 begann um 09:33 Uhr ein Angriff, der erst um 13:05 Uhr endete. Die Alarmdauer betrug drei Stunden und 31 Minuten. Das Diagramm in der Abbildung zeigt daraus einen Ausschnitt von zwei Stunden, von 11:05 bis 13:05 Uhr, weil die volle Dauer in einem Diagramm die Struktur verwischen würde.
In diesem Ausschnitt ist gut zu sehen, worin der Unterschied zum ersten Fall besteht. Es gibt keine einzelne Spitze, die kommt und geht. Die Kurve bewegt sich über zwei Stunden hinweg zwischen etwa 8 und 24 Millionen Paketen pro Sekunde, mit Dutzenden Einbrüchen und Wiederanstiegen. Das ist kein einzelner Schuss, sondern eine Folge von Wellen, die sich ohne Pause ablösen.
Der Höchstwert lag bei 501,2 Gbit/s und 43,9 Millionen Paketen pro Sekunde, also bei etwa der 30-fachen Paketrate und der 501-fachen Bandbreite eines Anschlusses mit 1 Gbit/s. Auch hier bestätigt sich die Messung selbst: 62.652,0 Prozent von 800 Mbit/s sind das 626,52-fache der Schwelle, und 626,52 mal 0,8 Gbit/s ergeben genau 501,2 Gbit/s.
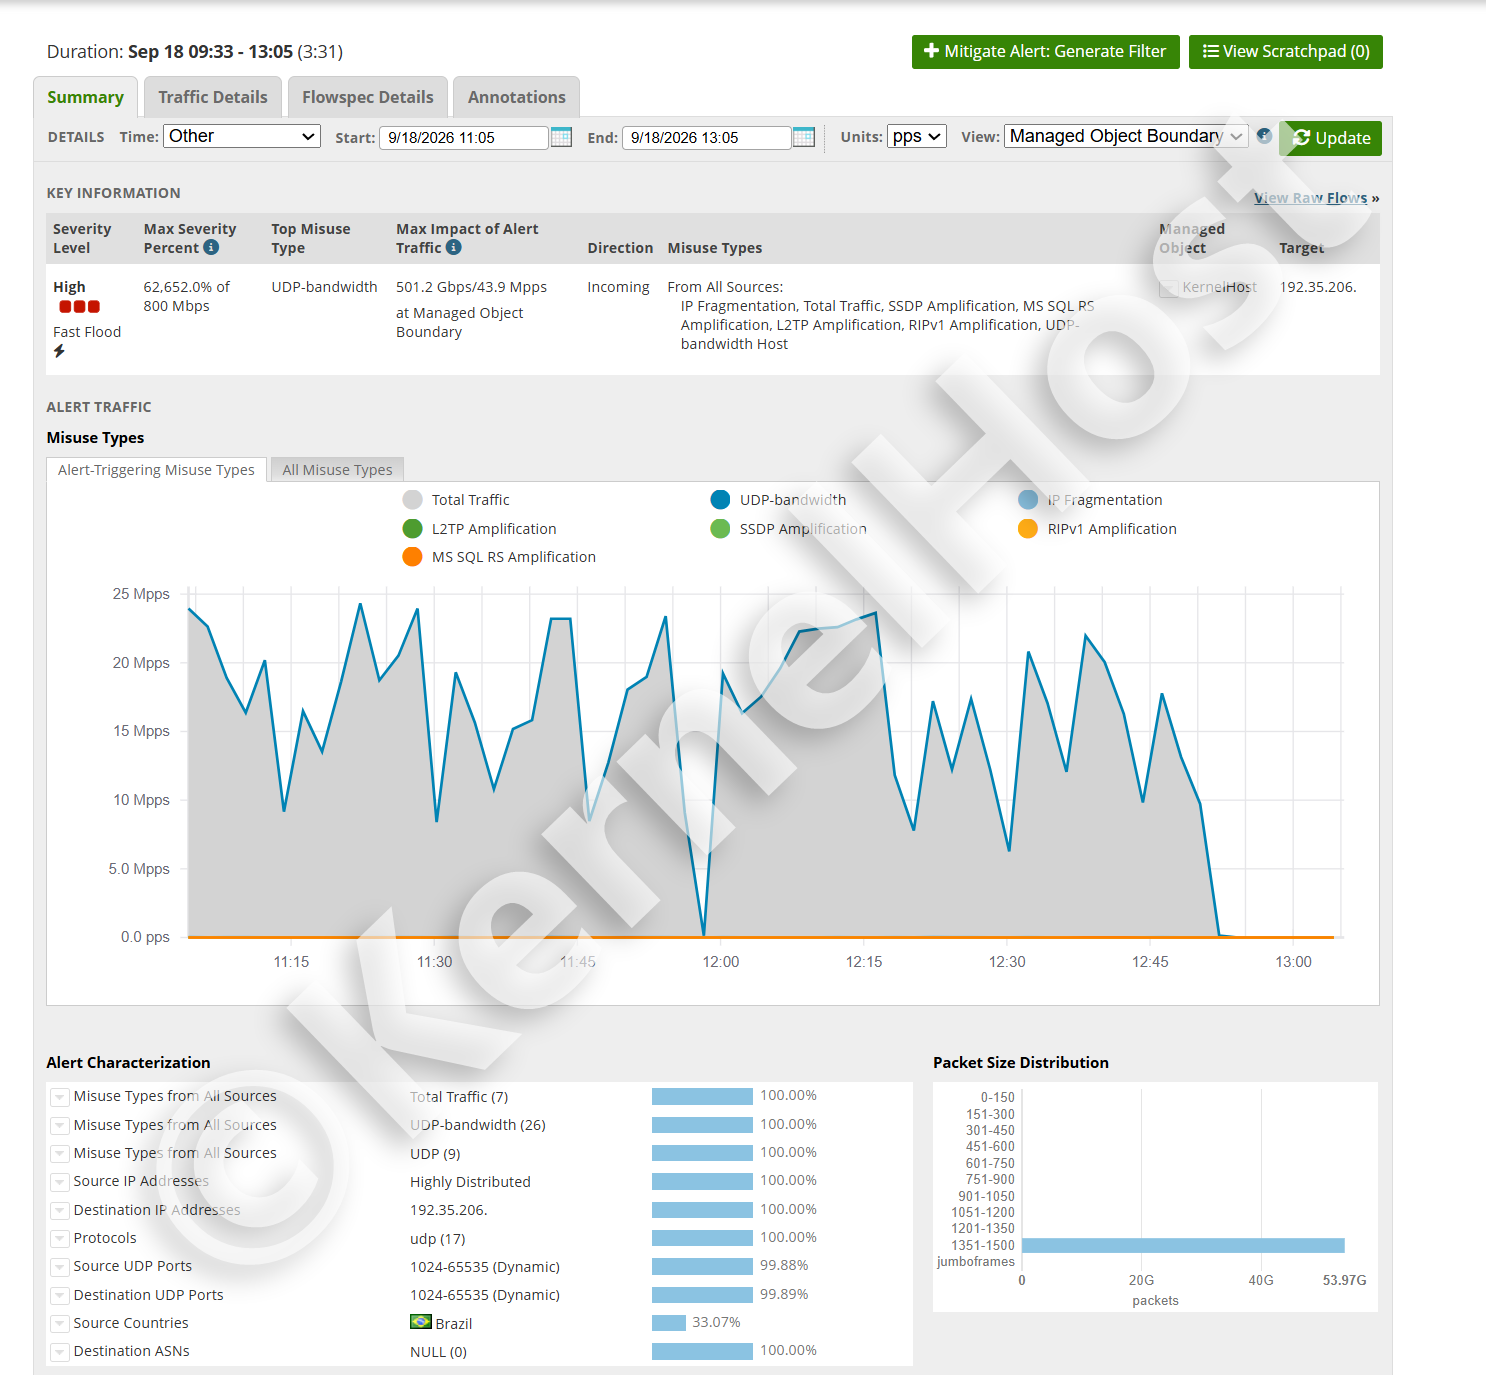
Allein in der größten Paketklasse, 1351 bis 1500 Byte, zählte das Monitoring in diesem Zweistundenfenster rund 53,97 Milliarden Pakete. Das sind, je nach genauer Größe, zwischen 73 und 81 Terabyte, die auf einen einzigen Server zuliefen und von denen nichts beim Server ankam.
Was diesen Angriff vom ersten unterscheidet
Drei Felder trennen die beiden Fälle deutlich voneinander, und jedes davon hat praktische Folgen.
Der Zielport. Im ersten Fall gingen 99,93 Prozent des Verkehrs auf Port 999, also auf einen Dienst. Im zweiten Fall verteilten sich 99,89 Prozent auf den gesamten Bereich 1024 bis 65535. Der Angreifer zielte nicht auf eine Anwendung, sondern auf die Adresse. Wer in so einem Fall den Dienst auf einen anderen Port legt, hat nichts gewonnen, weil der Angriff ohnehin alle hohen Ports gleichzeitig trifft.
Die Angriffsmuster. Im ersten Fall genügten drei Muster. Im zweiten Fall löste der Verkehr sieben gleichzeitig aus: IP Fragmentation, Total Traffic, SSDP Amplification, MS SQL RS Amplification, L2TP Amplification, RIPv1 Amplification und UDP-bandwidth Host. Das ist kein einzelnes Werkzeug mehr, das ist eine Kombination aus mindestens vier Verstärkungsvektoren plus direkt erzeugtem Verkehr.
Die Herkunft. Die Quelladressen waren auch hier hochverteilt, aber die Länderauswertung zeigt einen Schwerpunkt: 33,07 Prozent kamen aus Brasilien. Das heißt zugleich, dass zwei Drittel von anderswo kamen. Eine Sperre auf Länderebene hätte also ein Drittel des Verkehrs gestoppt und zwei Drittel durchgelassen, dafür aber einen Teil der echten Nutzer mit abgeschnitten.
Warum die Dauer das eigentliche Problem ist
Eine Spitze von 745 Gbit/s klingt dramatischer als 501 Gbit/s über dreieinhalb Stunden. In der Praxis ist der zweite Fall der anspruchsvollere, und zwar aus Gründen, die mit der Spitzenlast nichts zu tun haben.
Der kurze Angriff trifft die Technik
Ein Burst von wenigen Minuten ist eine reine Kapazitätsfrage. Entweder die Filterung sitzt vor der Leitung und hat genug Reserve, oder sie sitzt dahinter und ist wirkungslos. Wenn die Reserve da ist, passiert nichts, was über die Dauer hinaus nachwirkt. Der Angriff endet, die Zähler gehen zurück, und außer dem Eintrag im Monitoring bleibt nichts.
Deshalb kann ein kurzer, sehr harter Angriff sogar harmloser sein als ein mittelschwerer, der lange läuft. Entscheidend ist allein, ob die Filterung oberhalb der Engstelle greift. Alles, was auf dem Server selbst passiert, kommt zu spät: Wenn die Pakete den Netzadapter erreichen, ist die Leitung bereits voll.
Der lange Angriff trifft die Organisation
Dreieinhalb Stunden sind ein Arbeitszeitraum. In dieser Zeit laufen Dinge ab, die bei acht Minuten gar nicht erst anfangen: Monitoring-Systeme schicken Eskalationsstufen, Kunden schreiben Tickets, ein Spieleserver verliert seine Community für den Abend, ein Shop verliert eine Tagesspitze, ein Dienstleister bekommt Anrufe. Wer in dieser Lage improvisiert, macht Fehler.
Genau hier richten die beiden häufigsten Reaktionen den größten Schaden an. Die erste ist der Wechsel der IP-Adresse: Er funktioniert gegen einen Angreifer, der die neue Adresse nicht kennt, und er funktioniert nicht gegen einen, der den DNS-Eintrag beobachtet. Die zweite ist die Null Route. Sie beendet den Angriff auf der Leitung, aber sie beendet ihn, indem sie den Server vom Netz nimmt. Was dabei genau passiert, steht in Nullrouting und Null Route erklärt.
Was bei stundenlangem Beschuss zusätzlich bricht
Bei einem Dauerangriff zeigen sich Schwächen, die ein kurzer Burst nie erreicht. Zustandstabellen laufen voll, wenn die Filterung Zustand führen muss. Protokolldateien wachsen, bis die Partition voll ist, besonders wenn jede verworfene Verbindung eine Zeile schreibt. Metrik- und Flow-Erfassung erzeugt selbst Last, die mit der Paketrate skaliert. Und jede automatische Reaktion, die beim ersten Auslösen sinnvoll war, läuft nach drei Stunden immer noch und hat ihren Zweck längst verloren.
Deshalb ist das wichtigste Qualitätsmerkmal einer Abwehr nicht die Spitzenzahl im Datenblatt, sondern die Frage, ob sie nach drei Stunden noch genauso arbeitet wie in der ersten Minute. Im zweiten Fall oben lag zwischen Minute eins und Minute 211 kein Unterschied in der Wirkung.
Gbit/s oder Pakete pro Sekunde: welche Zahl zählt
In beiden Alarmen stehen zwei Zahlen nebeneinander, und sie bedeuten etwas vollkommen Verschiedenes. Die Bandbreite in Gbit/s sagt, ob die Leitung voll ist. Die Paketrate in Millionen Paketen pro Sekunde sagt, ob die Geräte an der Leitung noch mitkommen.
Die Rechnung hinter den beiden Fällen
Teilt man die Bandbreite durch die Paketrate, erhält man die mittlere Paketgröße. Im ersten Fall sind das rund 1275 Byte, im zweiten rund 1427 Byte. Beide Werte liegen nahe an der MTU von 1500 Byte, und beide passen zu den Verteilungen, deren Schwerpunkt jeweils bei 1351 bis 1500 Byte liegt.
Das ist kein Zufall, sondern eine bewusste Entscheidung des Angreifers. Große Pakete füllen die Leitung mit möglichst wenig Aufwand auf der Angreiferseite. Kleine Pakete füllen die Leitung kaum, bringen aber Geräte mit begrenzter Paketverarbeitung zum Erliegen. Wer die Leitung sättigen will, schickt große Pakete. Wer Hardware überlasten will, schickt kleine.
Warum große Pakete etwas anderes bedeuten als kleine
Ein Zahlenbeispiel macht den Unterschied deutlich. Bei 1500 Byte Nutzlast je Paket braucht es etwa 81.000 Pakete pro Sekunde, um 1 Gbit/s zu füllen. Bei kleinsten Rahmen von 64 Byte braucht es dafür etwa 1,49 Millionen Pakete pro Sekunde, also fast das 18-fache. Beide Zahlen zählen den vollständigen Rahmen auf dem Draht mit Präambel und Rahmenabstand. Dieselbe Bandbreite, eine völlig andere Belastung für jedes Gerät auf dem Weg.
Deshalb sind die 73,1 Millionen Pakete pro Sekunde aus dem ersten Fall die eigentlich bemerkenswerte Zahl. Sie entsprechen bei dieser Paketgröße einer Bandbreite, die kein einzelner Server und keine einzelne Leitung tragen kann. Die Filterung muss weit davor sitzen, sonst ist sie bedeutungslos. Mehr dazu steht in Was ist ein DDoS-Angriff.
Die Verstärkungsvektoren im zweiten Fall
Der lange Angriff setzte vier verschiedene Verstärkungsvektoren gleichzeitig ein. Das Prinzip ist bei allen dasselbe: Der Angreifer schickt eine kleine Anfrage mit gefälschter Absenderadresse an einen Dienst, der im Internet erreichbar ist und auf UDP antwortet. Die Antwort geht nicht an den Angreifer, sondern an das Opfer, und sie ist um ein Vielfaches größer als die Anfrage.
Der Reiz für den Angreifer liegt in genau diesem Faktor. Er muss nur einen Bruchteil der Bandbreite aufbringen, die beim Opfer ankommt, und er bleibt dabei hinter fremden Adressen verborgen. Die Faktoren unten stammen, wo nicht ausdrücklich anders angegeben, aus der Übersicht der US-amerikanischen Cybersicherheitsbehörde CISA zu UDP-basierten Verstärkungsangriffen.
SSDP, UDP-Port 1900
Das Simple Service Discovery Protocol gehört zu UPnP und dient dazu, Geräte im lokalen Netz zu finden: Drucker, Router, Smart-TVs, Netzwerkspeicher. Sehr viele dieser Geräte antworten versehentlich auch auf Anfragen aus dem Internet, weil UPnP im Auslieferungszustand aktiv ist und die Firmware nie aktualisiert wurde. CISA gibt für SSDP einen Verstärkungsfaktor von 30,8 an.
SSDP ist deshalb so verbreitet, weil die Zahl der nutzbaren Geräte riesig ist. Es handelt sich dabei nicht um Server, sondern um Endgeräte in Privathaushalten, und ihre Besitzer merken von ihrer Beteiligung nichts.
MS SQL Resolution Service, UDP-Port 1434
Der Microsoft SQL Server Resolution Service beantwortet die Frage, auf welchem Port eine benannte Datenbankinstanz lauscht. Die Anfrage ist ein einziges Byte, die Antwort enthält Instanznamen, Versionen und Ports und ist entsprechend länger. Dieser Dienst steht nicht in der CISA-Übersicht. Shadowserver und das irische NCSC geben die Verstärkung mit bis zu 25-fach an, einzelne veröffentlichte Messungen liegen deutlich darüber.
Dass dieser Dienst überhaupt aus dem Internet erreichbar ist, ist in nahezu allen Fällen ein Konfigurationsfehler. Ein Datenbankserver gehört nicht ungeschützt ins öffentliche Netz, und der Resolution Service erst recht nicht.
L2TP, UDP-Port 1701
Das Layer 2 Tunneling Protocol wird für VPN-Einwahl verwendet, meist in Verbindung mit IPsec. Wo die Gegenstelle ohne Authentisierung auf der UDP-Ebene antwortet, lässt sich der Dienst für Reflexion missbrauchen. Dieser Vektor ist jünger als die drei anderen und taucht vor allem deshalb auf, weil ältere Router und Einwahlkonzentratoren in großer Zahl im Netz stehen.
Wer selbst einen VPN-Dienst betreibt, sollte deshalb prüfen, ob der Einwahlport von beliebigen Adressen aus antwortet. Eine Anleitung dazu steht in VPN-Server vor DDoS schützen.
RIPv1, UDP-Port 520
Das Routing Information Protocol in der ersten Version stammt aus den achtziger Jahren und kennt keine Authentisierung. Ein Router, der RIPv1 spricht und aus dem Internet erreichbar ist, antwortet auf eine kurze Anfrage mit seiner gesamten Routing-Tabelle. CISA nennt dafür einen Verstärkungsfaktor von 131,24, den mit Abstand höchsten der vier hier verwendeten Vektoren.
RIPv1 sollte in keinem Netz mehr aktiv sein. Dass es den Weg in einen Angriff im Jahr 2026 findet, zeigt vor allem, wie lange vergessene Geräte im Netz stehen bleiben.
IP-Fragmentierung
Dieses Muster ist kein Verstärkungsvektor, sondern eine Folge der anderen. Wenn eine Antwort größer ist als die MTU des Weges, zerlegt der Absender sie in Fragmente. Beim Opfer kommen dann Teilpakete an, die wieder zusammengesetzt werden müssen, bevor überhaupt klar ist, was darin steht.
Das ist aus zwei Gründen unangenehm. Erstens kostet das Zusammensetzen Speicher und Zeit, und zwar bevor eine Filterentscheidung auf Anwendungsebene möglich wäre. Zweitens tragen die Folgefragmente keine Portnummern, weil der UDP-Kopf nur im ersten Fragment steht. Eine Filterregel, die nach Zielport entscheidet, greift bei ihnen also gar nicht. Beide Alarme oben zeigen IP Fragmentation als ausgelöstes Muster.
Wie lange Angriffe typischerweise dauern
Die beiden Fälle oben sind Einzelbeobachtungen, keine Statistik. Für die Einordnung lohnt trotzdem ein Blick auf die Struktur, weil sie erklärt, warum die Dauer so stark streut.
Die Verteilung hat einen langen Ausläufer
Der Normalfall sind Minuten. Das ist kein Zufall, sondern das Ergebnis der Preisgestaltung auf der Angreiferseite. Gemietete Angriffsdienste verkaufen Zeitfenster, und das kleinste Fenster ist das billigste. Wer einen Konkurrenten im Spiel ärgern will, kauft keine Stunde, er kauft eine Runde.
Lange Angriffe entstehen aus anderen Motiven. Erpressung braucht Dauer, weil die Drohung sonst nicht glaubwürdig ist. Angriffe gegen Shops oder Anbieter zielen auf einen ganzen Geschäftstag. Und manche lange Angriffe sind schlicht die Summe vieler kurzer, weil sich mehrere Besteller unabhängig voneinander an dasselbe Ziel hängen oder weil eine Automatik den Angriff neu startet, sobald das bezahlte Fenster abläuft.
Warum Sie die Dauer nicht vorhersagen können
Aus der ersten Minute lässt sich nicht ableiten, wie lange es weitergeht. Der Angriff mit 745,5 Gbit/s sah in den ersten Sekunden dramatischer aus als der, der dreieinhalb Stunden lief. Wer seine Reaktion davon abhängig macht, wie schlimm es sich anfühlt, entscheidet auf unsicherer Grundlage.
Die einzige Antwort, die unabhängig von der Dauer funktioniert, ist eine Filterung, die ohnehin immer läuft. Dann ist die Frage nach der Dauer keine Betriebsfrage mehr, sondern eine Frage der Neugier.
Warum Portwechsel und Adresswechsel selten helfen
Beide Maßnahmen werden in Angriffslagen fast reflexhaft vorgeschlagen, und beide scheitern an dem, was in den Alarmen oben steht.
Der Portwechsel hilft nur, wenn der Angriff auf einen Port zielt. Im ersten Fall traf er mit 99,93 Prozent genau einen Port, dort hätte ein Wechsel kurzfristig gewirkt, bis der Angreifer den neuen Port gefunden hätte. Im zweiten Fall verteilte er sich über den gesamten Bereich 1024 bis 65535. Dort gibt es keinen Port, auf den man ausweichen könnte.
Der Adresswechsel hilft nur, solange die neue Adresse unbekannt ist. Sobald ein DNS-Eintrag auf sie zeigt, ist sie öffentlich, und der Angriff folgt. Dazwischen liegen oft nur Minuten. Bei einem Angriff über dreieinhalb Stunden ist das keine Lösung, sondern eine Verzögerung. Wie Sie Ihre Adresse überhaupt aus der Öffentlichkeit heraushalten, steht in IP-Adresse schützen.
Was in einer akuten Lage wirklich in welcher Reihenfolge zu tun ist, steht in Schwerer DDoS-Angriff: was tun.
Was in diesen dreieinhalb Stunden bei KernelHost passiert ist
Die kurze Fassung: nichts, was den Kunden betroffen hätte. Der Dienst blieb erreichbar, es gab keine Umschaltung, keine Null Route und keinen Adresswechsel. Der Kunde musste nichts beantragen und nichts konfigurieren.
Der Grund dafür ist, dass die Filterung bei KernelHost nicht im Angriffsfall zugeschaltet wird, sondern dauerhaft aktiv ist: 17 Tbps Mitigationskapazität im globalen Scrubbing-Netzwerk, davor eine Arbor-Echtzeitfilterung mit 3,2 Tbps in Frankfurt am Main. Beides ist in jedem Serverpaket ohne Aufpreis enthalten und ab der Bereitstellung aktiv.
Der Unterschied zu einer Lösung, die erst bei einem Alarm umschaltet, zeigt sich genau bei einem Fall wie dem zweiten. Eine Umschaltung kostet Zeit, und sie kostet sie bei jeder Welle neu, wenn der Angriff zwischendurch abflaut und wieder anzieht. Die Kurve im zweiten Alarm hat Dutzende solcher Einbrüche. Jeder davon wäre bei einer umschaltenden Lösung ein möglicher Fehlentscheid gewesen.
Dass der Alarm überhaupt existiert, ist dabei kein Widerspruch. Gefiltert wird im Netz davor, protokolliert wird trotzdem, weil sonst niemand wüsste, was abgewehrt wurde. Die Alarme auf dieser Seite sind genau dieses Protokoll.
Was Sie selbst tun können, und was nicht
Gegen die Bandbreite eines Angriffs dieser Größe können Sie auf dem Server nichts ausrichten. Was Sie aber beeinflussen können, ist die Angriffsfläche und die Qualität Ihrer eigenen Messung.
Vor dem Angriff
Halten Sie die Adresse Ihres Servers aus der Öffentlichkeit heraus, soweit das geht. Jeder Dienst, der die Adresse ungefragt preisgibt, ist ein Startpunkt für einen Angriff. Das betrifft Statusseiten, Serverlisten, Fehlermeldungen mit vollständigen Hostnamen und alte DNS-Einträge, die auf dieselbe Maschine zeigen.
Schalten Sie ab, was nicht gebraucht wird. Jeder UDP-Dienst, der aus dem Internet antwortet, kann selbst zum Verstärker für andere werden. Die vier Vektoren aus dem zweiten Fall oben laufen ausschließlich über Geräte, deren Betreiber nichts davon wissen.
Richten Sie Ihre Messung so ein, dass Sie im Ernstfall Zahlen haben. Paketrate, Bandbreite und Zielport zum Zeitpunkt des Vorfalls sind die drei Angaben, mit denen sich eine Filterregel nachjustieren lässt. Ohne sie bleibt nur Vermutung.
Während des Angriffs
Messen Sie zuerst, bevor Sie etwas ändern. Wenn der Server noch antwortet, sichern Sie die Werte aus sar -n DEV 1 10, ip -s link show und ss -s. Diese Zahlen sind später nicht mehr rekonstruierbar, und sie entscheiden darüber, ob eine Nachjustierung überhaupt möglich ist.
Ändern Sie nicht mehrere Dinge gleichzeitig. Wer in einer laufenden Lage Firewall, Port und Adresse auf einmal anfasst, weiß hinterher nicht, was gewirkt hat, und hat im schlechteren Fall selbst den Ausfall verursacht, der ohne Zutun nicht eingetreten wäre.
Starten Sie den Server nicht neu. Ein Neustart ändert an einem Angriff aus dem Netz nichts, kostet aber die Zeit des Hochfahrens und verliert alle flüchtigen Messwerte.
Nach dem Angriff
Wenn Sie den Vorfall zur Anzeige bringen wollen, brauchen Sie Zeitstempel mit Zeitzone, die betroffene Adresse, den Zielport und die gemessene Last. Wie eine Anzeige in Österreich und Deutschland abläuft und was die Behörden tatsächlich verwerten können, steht in DDoS-Angriff melden und anzeigen.
Kurz zusammengefasst
Die meisten Angriffe dauern Minuten, weil sie minutenweise verkauft werden. Ein nennenswerter Teil dauert Stunden, und auf diesen Teil kommt es an, weil er nicht abzuwarten ist.
Die beiden Fälle in diesem Artikel zeigen beide Enden: 745,5 Gbit/s und 73,1 Millionen Pakete pro Sekunde in acht Minuten, und 501,2 Gbit/s über drei Stunden und 31 Minuten mit vier Verstärkungsvektoren gleichzeitig. Beide wurden vollständig gefiltert, beide ohne Nullrouting und ohne Zutun des Kunden.
Entscheidend ist nicht die höchste Zahl im Datenblatt, sondern dass die Filterung in Minute 211 genauso arbeitet wie in Minute eins. Alles, was erst umschalten muss, verliert bei jeder Welle Zeit, und eine Kurve wie im zweiten Fall besteht aus Dutzenden Wellen.
Läuft Ihr Projekt bereits bei KernelHost, ist die Filterung aktiv, ohne dass Sie etwas tun müssen. Bemerken Sie trotzdem einen Ausfall, bei dem der Server lokal einwandfrei antwortet, eröffnen Sie ein Support-Ticket mit Zeitpunkt, Adresse, Zielport und gemessener Paketrate, damit die Filterregeln für Ihre IP-Adresse nachjustiert werden. Bei einem laufenden Angriff erreichen Sie uns zusätzlich über den WhatsApp-Notfallchat unter +43 650 8209883.
Häufige Fragen
Wie lange dauert ein DDoS-Angriff im Durchschnitt?
Kann ein DDoS-Angriff mehrere Stunden dauern?
Ist ein langer Angriff schlimmer als ein kurzer?
Was bedeutet Fast Flood in einem Angriffsalarm?
Was bedeutet Max Severity Percent von 93.188 Prozent?
Was ist wichtiger, Gbit/s oder Pakete pro Sekunde?
Warum waren die Angriffspakete 1351 bis 1500 Byte groß?
Hilft ein Portwechsel gegen einen DDoS-Angriff?
Hilft ein Wechsel der IP-Adresse?
Was sind SSDP, MS SQL RS, L2TP und RIPv1 Amplification?
Warum taucht IP Fragmentation in beiden Alarmen auf?
Musste der Kunde während der dreieinhalb Stunden etwas tun?
Warum wird ein Angriff überhaupt protokolliert, wenn er gefiltert wird?
2026 KernelHost GmbH. Alle Rechte vorbehalten. Diese Anleitung ist urheberrechtlich geschützt. Eine Veröffentlichung auf anderen Webseiten, auch auszugsweise oder in bearbeiteter Form, ist ohne unsere schriftliche Zustimmung nicht gestattet. Zitate mit Quellenangabe und Link sind ausdrücklich willkommen.



