Qu'est-ce qu'une attaque DDoS ? Technique, niveaux et défense
Comment une attaque DDoS se déroule techniquement, quelles quatre ressources finies elle occupe, comment la reconnaître à partir de vos propres mesures et où la défense sur le serveur s'arrête. Avec des cas d'attaque réels tirés de notre exploitation.
Une attaque DDoS est la tentative de rendre un service injoignable au moyen d'une surcharge produite artificiellement, menée simultanément par un très grand nombre d'expéditeurs différents. L'abréviation signifie Distributed Denial of Service, donc un déni de service provoqué de façon distribuée. Ce qui est attaqué n'est ni le contenu d'un serveur ni une faille de sécurité dans son logiciel, mais une ressource qui est finie : la bande passante du raccordement, le taux de paquets de la carte réseau, une place dans une table d'états du noyau ou le temps de calcul que l'application consacre à une seule requête. Dès que l'une de ces quatre ressources est occupée, les vrais utilisateurs ne passent plus, et cela sans que personne se soit introduit dans le système.
Cet article est l'entrée en matière sur le sujet. Il explique les trois niveaux sur lesquels les attaques se déroulent, avec quels facteurs d'amplification un octet de requête devient 51 000 octets de réponse, d'où vient la capacité d'attaque et ce qu'elle coûte sur le marché, comment reconnaître une attaque à partir de vos propres mesures, ce qui aide encore sur le serveur lui-même et où passe exactement cette limite. Tous les chiffres sont donnés avec leur source, afin que vous puissiez les vérifier. Si votre service est actuellement à l'arrêt, lisez d'abord la section « Ce qu'il faut faire en cas d'attaque » et mesurez au lieu de bricoler.
Ce qu'est techniquement une attaque DDoS
Toute attaque DDoS vit d'une asymétrie : envoyer un paquet doit coûter moins à l'attaquant que traiter ce paquet ne coûte à la cible. Tout le reste n'est que la question de l'endroit où cette asymétrie est la plus grande. Il existe exactement quatre endroits, et chacun a une limite supérieure dure, qui se calcule.
La bande passante du raccordement. Un raccordement à 1 Gbit/s transporte 125 mégaoctets par seconde, pas davantage. Qui envoie plus produit des pertes, et ces pertes frappent les paquets de vos utilisateurs tout autant que ceux de l'attaquant, parce qu'un raccordement saturé ne choisit pas.
Le taux de paquets. Le plus petit paquet Ethernet admissible mesure 64 octets et occupe, préambule et intervalle entre paquets compris, 84 octets sur la ligne. Il en tient environ 1,49 million par seconde dans 1 Gbit/s. Un noyau de serveur ordinaire en traite, selon le CPU et la carte réseau, quelques centaines de milliers avant de commencer à rejeter. Le taux de paquets est donc presque toujours la limite atteinte avant la bande passante.
Les tables d'états. Le noyau garde en mémoire les connexions TCP à demi ouvertes et les flux de paquets. Ces tables sont limitées en nombre d'entrées, pas en bits par seconde. Elles se remplissent avec très peu de bande passante dès que chaque paquet porte une nouvelle adresse d'expéditeur.
Le temps de calcul de l'application. Une recherche, une tentative de connexion avec vérification de mot de passe ou une requête de serveur qui renvoie une liste de mods entière coûte mille fois plus à la cible qu'à l'expéditeur. Ici, une attaque efficace n'a souvent même pas besoin de 10 Mbit/s.
DoS et DDoS : la différence que l'on peut mesurer
La base terminologique est fournie par la RFC 4732, « Internet Denial-of-Service Considerations », une publication informative de l'IETF de novembre 2006. On y lit textuellement : « A Denial-of-Service (DoS) attack is an attack in which one or more machines target a victim and attempt to prevent the victim from doing useful work. » Une attaque DoS se définit donc par son effet, non par le nombre de sources. Elle est distribuée, donc DDoS, lorsque ces sources sont nombreuses et indépendantes les unes des autres.
En pratique, la différence compte à un seul endroit : sur la longueur de votre liste de blocage. Une attaque DoS venant d'une seule source, vous y mettez fin avec une règle. Cloudflare a documenté en mai 2025 une attaque provenant de 122 145 adresses sources différentes, réparties sur 161 pays et 5 433 systèmes autonomes, en moyenne 26 855 nouvelles adresses par seconde, 45 097 au pic. Contre une telle chose, il n'existe aucune liste de blocage qui grandisse assez vite, et chaque entrée qu'elle contient coûte en plus de la mémoire et du temps de recherche sur l'équipement qui est de toute façon déjà surchargé.
Le guide commun « Understanding and Responding to Distributed Denial-of-Service Attacks » de la CISA, du FBI et du MS-ISAC répartit les attaques en exactement trois techniques : volumétrique, protocolaire et applicative. Cette tripartition est la plus utile qui existe, parce qu'elle décrit en même temps laquelle de vos quatre ressources est attaquée et où la défense doit se trouver.
Les trois niveaux d'une attaque DDoS
Attaques volumétriques sur les couches 3 et 4
Une attaque volumétrique ne veut rien d'autre que remplir le raccordement en amont de la cible. La mesure se fait en bits par seconde. Le moyen employé est en règle générale un flood UDP, parce que UDP ne connaît aucun établissement de connexion que l'on pourrait exiger et parce que les adresses d'expéditeur se falsifient.
L'exemple le plus grand actuellement documenté publiquement : Cloudflare rapporte pour la période allant jusqu'à fin 2025 une attaque rejetée automatiquement à 31,4 Tbit/s, qui a duré 35 secondes. C'est la capacité d'environ 31 400 raccordements de serveur à 1 Gbit/s, en même temps, pendant une bonne demi-minute. Le même rapport contient une seconde valeur, qui rend l'ordre de grandeur plus tangible que le pic : en 2025, le même exploitant a rejeté 47,1 millions d'attaques DDoS, soit 121 pour cent de plus que l'année précédente, en moyenne 5 376 attaques par heure.
Le cas mieux documenté de mai 2025 montre à quoi ressemble une telle attaque quand on la décompose : 7,3 Tbit/s au pic, 37,4 téraoctets de données en 45 secondes, soit en moyenne environ 830 gigaoctets par seconde. Un raccordement à 1 Gbit/s aurait eu besoin de trois bons jours pour le même volume de données. 99,996 pour cent du trafic étaient de purs floods UDP, répartis sur 21 925 ports cibles simultanés en moyenne, 34 517 au pic. Cette répartition sur tous les ports est typique : l'attaquant ne sait pas quel port est important, alors il prend tous les ports.
Attaques protocolaires : les tables, pas le raccordement
Une attaque protocolaire exploite le fait que le noyau doit mémoriser des états. L'exemple de référence est le SYN flood : l'attaquant envoie des paquets TCP avec le bit SYN positionné et une adresse d'expéditeur falsifiée, le serveur crée pour chacun une entrée dans sa file d'attente des connexions à demi ouvertes, répond par un SYN-ACK à une adresse qui n'a jamais rien demandé, puis attend. Ici, la mesure se fait en paquets par seconde, pas en gigabits.
La longueur de cette file d'attente figure dans net.ipv4.tcp_max_syn_backlog et se situe sur un serveur ordinaire dans l'ordre de quelques milliers. Une file d'attente de 1 024 places est pleine en moins d'une milliseconde face à 1,49 million de paquets SYN par seconde. Pour cela, 1 Gbit/s suffit en pur calcul, et si la table seule est la cible, une fraction de cette valeur suffit.
À la même famille appartient un procédé qui n'a été décrit qu'en 2021 : la réflexion TCP par des équipements intermédiaires à états. Le travail « Weaponizing Middleboxes for TCP Reflected Amplification » montre que les pare-feu et les infrastructures de censure qui ne suivent l'état TCP qu'à moitié répondent à un unique paquet falsifié par des pages entières de réponse. Cela permet pour la première fois de détourner aussi TCP pour l'amplification, ce qui était jusque-là considéré comme pratiquement impossible.
Attaques applicatives sur la couche 7
Une attaque applicative ressemble à du trafic ordinaire parce qu'elle est du trafic ordinaire, seulement en quantité fausse. La mesure se fait en requêtes par seconde. Elle arrive par une connexion entièrement établie, survit donc à tout contrôle qui n'évalue que l'établissement de connexion, et elle a besoin de peu de bande passante : 10 000 requêtes HTTP par seconde représentent, selon la taille des requêtes, moins de 50 Mbit/s, et suffisent malgré tout à mettre une base de données à genoux.
La référence en la matière s'appelle HTTP/2 Rapid Reset, divulguée le 10 octobre 2023 sous la référence CVE-2023-44487. La faille réside dans la capacité de multiplexage de HTTP/2 : l'attaquant ouvre un flux, envoie la requête et interrompt aussitôt le flux. Le serveur a déjà commencé le travail, l'attaquant dispose en revanche immédiatement d'une place libre dans la fenêtre. Les valeurs atteintes ainsi ont été de 201 millions de requêtes par seconde (Cloudflare), 398 millions (Google) et 155 millions (Amazon). À titre de comparaison : la plus forte attaque de couche 7 mesurée jusque-là par Cloudflare atteignait 71 millions de requêtes par seconde.
Chez les serveurs de jeu, le niveau de la couche 7 est l'établissement de connexion lui-même. Les floods Nullping, QuietException et de faux handshakes contre les réseaux Minecraft n'ont presque besoin d'aucune bande passante et paralysent des ensembles de proxys entiers, parce que chaque paquet contraint le proxy à une décision d'état coûteuse. À quoi ressemblent exactement ces schémas, l'article Protection DDoS et protection Nullping pour Minecraft l'explique.
Les trois niveaux comparés
| Niveau | Ce qui est attaqué | Unité de mesure | Procédés typiques | Où la défense doit se trouver |
|---|---|---|---|---|
| Volumétrique (couches 3 et 4) | Bande passante du raccordement | Gbit/s et Tbit/s | flood UDP, attaques par amplification via DNS, NTP, memcached, CLDAP | exclusivement dans le réseau, en amont du serveur |
| Protocolaire (couches 3 et 4) | Tables d'états du noyau, du pare-feu et du répartiteur de charge | Paquets par seconde | SYN flood, ACK flood, paquets fragmentés, réflexion TCP par équipements intermédiaires | en partie sur le serveur, au-delà de quelques centaines de milliers de paquets par seconde en amont |
| Applicative (couche 7) | Temps de calcul, base de données, établissement de connexion de l'application | Requêtes par seconde | flood HTTP, HTTP/2 Rapid Reset, flood de connexions, flood de requêtes, épuisement des slots | dans l'application et dans le filtrage en amont, les deux ensemble |
Les attaques réelles ne respectent pas cette classification. Le cas le plus désagréable en pratique est l'attaque multicouche : une part volumétrique qui occupe le raccordement, plus une part de couche 7 qui passe au moment même où l'attention porte sur la bande passante. L'une des attaques filtrées chez KernelHost montrées plus bas se composait de plus de douze schémas principaux différents simultanés.
Attaques par amplification : comment un octet en devient 51 000
Une attaque par amplification est une attaque dans laquelle l'attaquant ne tire pas lui-même sur la cible, mais amène des services tiers accessibles publiquement à le faire pour lui. Il envoie une petite requête à un service ouvert et inscrit comme expéditeur l'adresse IP de la victime. Le service répond comme il le doit, mais à la victime, et la réponse est plusieurs fois plus grande que la requête.
Le rapport entre la taille de la réponse et celle de la requête s'appelle Bandwidth Amplification Factor, en abrégé BAF. Un BAF de 50 signifie qu'un attaquant disposant de 1 Gbit/s de raccordement propre dirige 50 Gbit/s sur la cible. Deux conditions doivent être réunies pour que cela fonctionne : un protocole sur UDP qui répond plus qu'on ne l'interroge, et la possibilité de falsifier l'adresse d'expéditeur. C'est pourquoi l'IP spoofing est la condition de toute attaque par amplification et pas seulement une tactique de dissimulation.
Pour le défenseur, il en découle une propriété désagréable : le trafic vient de serveurs réels et légitimes. Ce sont de vrais résolveurs DNS, de vrais serveurs de temps, de vrais serveurs de jeu. Une liste de blocage par adresse source bloque donc soit des demi-pays, soit rien du tout.
Les facteurs d'amplification des protocoles détournés
Les facteurs suivants proviennent de l'alerte TA14-017A de l'US-CERT, respectivement de la CISA, « UDP-Based Amplification Attacks », étendue en continu depuis 2014. C'est la référence à laquelle se rapporte l'ensemble du secteur.
| Protocole | Facteur d'amplification | Opération détournée |
|---|---|---|
| memcached (port 11211) | 10 000 à 51 000 | récupération de contenus mis en cache |
| NTP (port 123) | 556,9 | requête monlist |
| CharGEN (port 19) | 358,8 | générateur de caractères |
| WS-Discovery (port 3702) | 10 à 500 | recherche d'équipements sur le réseau |
| QOTD (port 17) | 140,3 | requête de citation |
| RIPv1 (port 520) | 131,24 | requête de routes malformée |
| CLDAP (port 389) | 56 à 70 | requête d'annuaire malformée |
| Protocole Quake | 63,9 | information de serveur |
| TFTP (port 69) | 60 | demande de fichier |
| LDAP (port 389) | 46 à 55 | requête d'annuaire malformée |
| DNS (port 53) | 28 à 54 | requête avec réponse volumineuse |
| SSDP (port 1900) | 30,8 | requête SEARCH |
| Portmap / RPCbind (port 111) | 7 à 28 | requête malformée |
| Kad | 16,3 | échange de la liste des nœuds |
| mDNS (port 5353) | 2 à 10 | requête en unicast |
| SNMPv2 (port 161) | 6,3 | requête GetBulk |
| Protocole Steam | 5,5 | requête de serveur |
| NetBIOS (port 137) | 3,8 | résolution de noms |
| BitTorrent | 3,8 | recherche de fichiers |
Ce tableau explique pourquoi la liste des ports bloqués se ressemble dans tout pare-feu bien tenu. Ce que vous pouvez faire vous-même est limité, mais important : vérifiez avec ss -lnup si un service de ce tableau est ouvert sur le réseau depuis votre serveur. Un memcached qui n'est pas attaché à 127.0.0.1 fait de votre serveur une arme contre des tiers, vous coûte votre propre bande passante sortante et place votre adresse IP sur des listes de blocage d'où elle ressort difficilement.
Pourquoi les protocoles de requête de jeu en font partie
Les serveurs de jeu figurent dans ce tableau avec deux rôles. Ils sont amplificateurs, parce que leur port de requête répond à un petit paquet par le nom, la carte, le nombre de joueurs et la liste complète des mods. Et ils sont victimes, parce que cette même requête coûte du temps de calcul, souvent précisément sur le cœur qui porte la simulation du jeu.
Le facteur d'amplification du protocole Steam est faible, à 5,5, celui du plus ancien protocole Quake est élevé, à 63,9. Mais l'effet ne dépend pas du seul facteur, il dépend de la taille de la réponse au cas par cas : un serveur avec 200 mods livre une réponse nettement plus grande qu'un serveur sans mods. Bohemia Interactive documente pour Arma 3, sous le ticket T83469 et depuis 2015, que 4 Mbit/s de requêtes falsifiées vers le port de requête Steam suffisaient déjà à geler un serveur. Quatre mégabits par seconde, c'est moins que ce qu'un seul raccordement domestique peut produire.
Il en découle la règle qui vaut pour tous les jeux : limiter le port de requête, ne pas le bloquer. Qui le bloque disparaît de la liste des serveurs et n'est plus trouvé par les nouveaux joueurs. Quel est ce port pour chaque jeu et à quel point il peut être mené serré, cela figure dans les articles propres à chaque jeu plus bas, par exemple pour Arma 3, CS2 et les titres Source ou Rust.
Le cas memcached : 1,35 Tbit/s contre GitHub
Le 28 février 2018, GitHub était injoignable de 17h21 à 17h26 UTC et n'était joignable que par intermittence jusqu'à 17h30 UTC. L'attaque a atteint 1,35 Tbit/s à 126,9 millions de paquets par seconde et provenait de plus de 1 000 systèmes autonomes différents et de dizaines de milliers de terminaux individuels. Elle a été amplifiée via memcached, avec un facteur allant jusqu'à 51 000 : un octet de l'attaquant produisait jusqu'à 51 kilooctets en direction de la cible.
Ce cas reste à ce jour le meilleur exercice d'école, parce qu'il montre trois choses à la fois. Premièrement : l'amplification bat la taille du botnet. L'attaquant n'a pas eu besoin de cent mille appareils, il a eu besoin d'instances memcached ouvertes, dont plus de 90 000 étaient alors présentes sur le réseau dans le monde. Deuxièmement : 126,9 millions de paquets par seconde représentent environ 85 fois ce qu'un raccordement à 1 Gbit/s peut transporter au total. Aucun réglage sur le serveur n'y change quoi que ce soit. Troisièmement : la défense a fonctionné parce que le trafic a été dérouté vers un réseau de filtrage, et l'indisponibilité s'est ainsi terminée au bout de neuf minutes au lieu de neuf heures.
D'où vient la capacité nécessaire à une attaque DDoS
Botnets composés d'appareils détournés
Un botnet est un ensemble d'appareils tiers, pris en main par un logiciel malveillant, qu'un attaquant télécommande de façon centralisée. Les propriétaires ne s'en aperçoivent en règle générale pas, parce que l'appareil continue de faire ce pour quoi il a été acheté. Sont attaqués avant tout les appareils qui restent en permanence sur le réseau, qui sont rarement mis à jour et qui portent des mots de passe par défaut : routeurs, caméras de surveillance, enregistreurs réseau, boîtiers de télévision.
La référence est Mirai, dont le code source a été publié fin septembre 2016. Le travail « Understanding the Mirai Botnet » (USENIX Security 2017) suit le réseau pendant sept mois et chiffre le point culminant à plus de 600 000 appareils infectés. L'attaque contre le site de Brian Krebs en septembre 2016 a atteint 620 Gbit/s et provenait de plus de 175 000 appareils. Lors de l'attaque contre l'exploitant DNS Dyn le 21 octobre 2016, qui a rendu Twitter, Spotify et Reddit injoignables en même temps, environ 107 000 adresses IP attaquantes ont été comptées.
Neuf ans plus tard, l'ordre de grandeur est différent. Cloudflare attribue l'attaque record de 31,4 Tbit/s à un botnet dont la taille est estimée entre un et quatre millions d'appareils infectés, majoritairement des boîtiers de télévision Android. Dans la vague d'attaques de décembre 2025, 902 attaques hypervolumétriques ont été comptées, soit 53 par jour en moyenne, avec des pics de 9 milliards de paquets par seconde, de 24 Tbit/s et de 205 millions de requêtes par seconde. La taille des botnets a ainsi été multipliée par 5 en une décennie, la bande passante atteinte par 50.
Services de booter et de stresser, et ce que coûte une attaque
Entre le botnet et le donneur d'ordre se trouve un service qui vend la capacité d'attaque par abonnement. Ces services se présentent comme « booter », « stresser » ou « IP stresser » et affirment dans leurs conditions d'utilisation qu'ils servent au test de charge de vos propres systèmes. Ils ne vérifient jamais au passage si la cible inscrite appartient à l'utilisateur, et c'est précisément là la différence entre un outil et une offre.
L'utilisation se résume à une interface web avec trois champs : cible, port, durée. Il y a des procédures de paiement, un service client et des programmes de revente. Les offres d'entrée de gamme se situent autour de 10 à 20 euros par mois, les offres plus importantes, avec davantage de bande passante et une durée d'attaque plus longue, à quelques centaines d'euros par mois. Voilà qui répond à la question de savoir pourquoi les petits projets sont touchés aussi : une attaque qui coûte à un serveur de jeu sa soirée du samedi coûte à celui qui la déclenche moins que deux places de cinéma, et aucune connaissance technique.
De l'autre côté se tient une pression judiciaire permanente. Lors de la semaine d'action de l'opération internationale PowerOFF en avril 2026, les autorités de 21 pays ont saisi 53 domaines de tels services, arrêté quatre personnes et mené 25 perquisitions. Les enquêteurs ont à cette occasion obtenu l'accès aux données de plus de trois millions de comptes d'utilisateurs, et plus de 75 000 utilisateurs identifiés ont reçu un courrier. En décembre 2024, 27 plateformes avaient été fermées dans le cadre de la même opération. Qui paie un tel service laisse donc une trace de paiement dans une base de données qui sera saisie tôt ou tard.
Comment reconnaître une attaque DDoS
Ce que rapportent les utilisateurs, et ce que cela indique déjà
La première information vient presque toujours des utilisateurs, et elle est plus exploitable qu'elle n'en a l'air. Quatre signalements ont une signification claire :
- « Tout le monde a été déconnecté en même temps. » Une coupure simultanée chez tous les utilisateurs plaide pour le raccordement ou le processus de service, pas pour des connexions isolées. Un problème de charge touche les utilisateurs l'un après l'autre.
- « Le ping passe de 20 à 400 et revient. » Une latence fluctuante alors que la connexion subsiste est le schéma d'une file d'attente saturée en amont de la cible, pas celui d'un processus surchargé.
- « La liste des serveurs nous affiche hors ligne, mais je peux me connecter. » C'est l'indice d'un flood de requêtes : le port de requête ne répond plus, le port de jeu répond encore.
- « Par le réseau mobile j'arrive à entrer, par mon raccordement non. » Un comportement différent selon le réseau d'accès indique que ce n'est pas votre serveur qui est saturé, mais un chemin qui y mène.
Les quatre mesures à prendre sur le serveur
Ensuite on mesure, et dans cet ordre : taux de paquets, bande passante, états de connexion, compteurs de rejets. L'indicateur de charge du CPU vient en dernier, parce qu'il reste souvent discret lors d'une attaque réseau.
sar -n DEV 1 10
ip -s link show eth0
ss -s
ss -tn state syn-recv | wc -l
nstat -az TcpExtListenDrops TcpExtListenOverflows TcpExtTCPReqQFullDrop UdpRcvbufErrors UdpInErrors UdpNoPorts
cat /proc/sys/net/netfilter/nf_conntrack_count /proc/sys/net/netfilter/nf_conntrack_max
sar -n DEV 1 10 livre les paquets et les octets par seconde par interface sur dix secondes. Ce qui est déterminant, c'est le rapport : beaucoup de paquets pour peu d'octets signifie de petits paquets, donc une attaque protocolaire. Peu de paquets pour énormément d'octets signifie de grands paquets, donc une attaque par amplification. ip -s link show montre dans les colonnes dropped et overrun si le noyau rejette déjà. ss -tn state syn-recv compte les connexions à demi ouvertes : une valeur à trois chiffres est normale, une valeur à cinq chiffres est un SYN flood. Et nstat livre les compteurs qui subsistent, même une fois l'attaque terminée.
L'étape la plus importante est celle que presque personne ne franchit à l'avance : constituer une base de comparaison pendant que tout fonctionne normalement. Sans valeur de référence, vous ne pouvez pas dire si 40 000 paquets par seconde représentent beaucoup ou simplement un samedi soir. Avec apt-get install -y vnstat sysstat, la mesure tourne en permanence. Le guide détaillé de l'interprétation figure dans Détecter une attaque DDoS.
Les lignes de journal qui ne laissent aucun doute
Quatre messages dans le journal du noyau et dans le journal du serveur web sont pratiquement des preuves. dmesg -T | tail -50 montre les trois premiers :
kernel: TCP: request_sock_TCP: Possible SYN flooding on port 443. Sending cookies.  Check SNMP counters.
kernel: nf_conntrack: nf_conntrack: table full, dropping packet
kernel: net_ratelimit: 2247 callbacks suppressed
nginx: [alert] 1123#1123: 768 worker_connections are not enough
La première ligne signifie que la file d'attente des connexions à demi ouvertes a débordé et que le noyau est passé aux SYN cookies. Si à la place on y lit Dropping request, c'est que net.ipv4.tcp_syncookies est à 0, et le serveur rejette des requêtes, y compris les vraies. La deuxième ligne signifie que le suivi de connexions est saturé, et à partir de cet instant le serveur rejette aussi le trafic légitime. La troisième ligne est un effet secondaire : le noyau supprime des messages, parce qu'il serait sinon occupé à journaliser. La quatrième ligne déplace le problème dans l'application.
Dans le journal d'accès du serveur web, deux choses sont parlantes. Une part soudaine du code de statut 499 signifie que le client ferme la connexion avant que la réponse soit terminée, et c'est exactement ce que fait une attaque de couche 7 qui veut seulement déclencher du travail et non lire le résultat. Et un champ Referrer vide sur presque toutes les requêtes distingue une attaque d'un véritable afflux de visiteurs, qui apporte des referrers venant des moteurs de recherche et des réseaux sociaux.
La contre-épreuve : attaque, afflux ou erreur de votre côté
| Observation | Cause probable | Mesure suivante |
|---|---|---|
| Taux de paquets entrants élevé, charge CPU faible | attaque volumétrique ou protocolaire | calculer la taille des paquets en divisant les octets par les paquets |
| Charge CPU élevée, taux de paquets normal | attaque de couche 7 ou erreur de votre côté dans l'application | parcourir le journal d'accès à la recherche d'une URL récurrente et du code de statut 499 |
Par 127.0.0.1 le service répond vite, depuis l'extérieur non |
le problème est le réseau, pas l'application | vérifier les compteurs de rejets de l'interface et la latence depuis l'extérieur |
| La charge revient aussitôt après un redémarrage du service | attaque venant de l'extérieur | compter les adresses sources, pas les connexions |
| Énormément de connexions depuis très peu d'adresses | source isolée, blocable | poser une limitation de débit par adresse source |
| Très peu de connexions depuis énormément d'adresses | attaque distribuée, non blocable | filtrage en amont du serveur, impliquer l'hébergeur |
| Nettement plus de trafic sortant que de trafic entrant | véritable afflux de visiteurs, ou votre serveur amplifie contre des tiers | vérifier les services UDP ouverts avec ss -lnup |
| Début exactement après un redémarrage, une mise à jour ou un passage de cron | erreur de votre côté | annuler la modification et mesurer de nouveau |
Ce qui aide sur le serveur lui-même
Sur le serveur, on peut obtenir davantage qu'on ne l'affirme souvent, et cela contre tout ce qui reste petit : bots mal écrits, sources isolées, floods de requêtes et attaques applicatives. Les outils pour cela sont nftables, le suivi de connexions, les SYN cookies et une limitation de débit par adresse source. Toutes les indications qui suivent valent pour Debian 12, Debian 13, Ubuntu 22.04 LTS et Ubuntu 24.04 LTS et sont écrites pour root.
nftables : rejeter tôt, calculer peu
Le principe est le suivant : un paquet qui sera rejeté doit l'être aussi tôt et aussi économiquement que possible. Chaque règle qui s'exécute avant coûte du temps de calcul multiplié par le taux de paquets. Le jeu de règles suivant pour /etc/nftables.conf laisse passer un serveur web et un service de jeu et rejette le reste, avec une limitation de débit des nouvelles connexions TCP par adresse source :
#!/usr/sbin/nft -f

flush ruleset

table inet filter {
    set adminips {
        type ipv4_addr
        flags interval
        elements = { 203.0.113.10 }
    }

    set newconn {
        type ipv4_addr
        size 131072
        flags dynamic,timeout
        timeout 1m
    }

    chain input {
        type filter hook input priority filter; policy drop;

        iif lo accept
        ct state established,related accept
        ct state invalid counter drop

        ip saddr @adminips tcp dport 22 accept

        tcp dport { 80, 443 } ct state new add @newconn { ip saddr limit rate over 30/second burst 60 packets } counter drop
        tcp dport { 80, 443 } accept

        udp dport 25565 accept

        icmp type echo-request limit rate 5/second accept
        icmpv6 type { echo-request, nd-neighbor-solicit, nd-neighbor-advert, nd-router-solicit, nd-router-advert } accept

        counter drop
    }

    chain forward { type filter hook forward priority filter; policy drop; }
    chain output  { type filter hook output  priority filter; policy accept; }
}
Inscrivez votre propre adresse fixe sous adminips avant de charger le jeu de règles, sinon vous vous bloquez l'accès SSH. La vérification et l'activation se font ainsi :
nft -c -f /etc/nftables.conf
systemctl enable --now nftables
nft list ruleset
nft list set inet filter newconn
Trois points décident de l'efficacité. ct state established,related accept figure volontairement en deuxième règle, afin que les connexions existantes ne parcourent pas l'ensemble du jeu de règles. ct state invalid counter drop élimine les combinaisons de drapeaux erronées et les fragments tardifs, sans que vous ayez à les décrire un par un. Et le counter devant chaque drop est la raison pour laquelle vous saurez après coup quelle règle a agi : si les compteurs restent à zéro, la règle n'est pas atteinte, et c'est un diagnostic tout autre qu'un jeu de règles sans effet.
SYN cookies et la limite du backlog
Les SYN cookies sont un procédé par lequel le serveur ne mémorise pas une connexion à demi ouverte, mais inscrit les indications nécessaires, chiffrées, dans son propre numéro de réponse. Lorsque le troisième paquet de l'établissement de connexion revient, il en recalcule l'état. La file d'attente ne débordera donc plus, puisqu'il n'existe plus de file d'attente pour ces connexions.
net.ipv4.tcp_syncookies = 1
net.ipv4.tcp_timestamps = 1
net.ipv4.tcp_max_syn_backlog = 8192
net.core.somaxconn = 8192
net.core.netdev_max_backlog = 16384
net.core.rmem_max = 16777216
Ces valeurs ont leur place dans un fichier sous /etc/sysctl.d/ et sont prises en compte avec sysctl --system, faute de quoi elles auront disparu au prochain redémarrage. Sur Debian et Ubuntu, tcp_syncookies est à 1 par défaut, ce qui est juste. La valeur 1 ne signifie pas « toujours des cookies », mais « des cookies dès que la file d'attente déborde ».
Le prix à payer est réel et rarement mentionné. Un cookie n'a pas de place pour les options TCP de l'autre partie. Linux ne sauve l'agrandissement de fenêtre et l'accusé de réception sélectif que si net.ipv4.tcp_timestamps est à 1, parce que ces indications voyagent alors dans l'horodatage. Sans horodatage, elles disparaissent, et la connexion reste plus lente pour le reste de sa durée de vie. Par ailleurs, seuls trois bits sont disponibles pour la taille maximale de paquet, donc huit paliers grossiers au lieu de la valeur exacte. Les SYN cookies sont un mode de secours qui sauve des connexions, pas un réglage pour le fonctionnement normal.
conntrack : la table qui est saturée la première
Le suivi de connexions du noyau crée une entrée pour chaque flux de paquets, y compris pour UDP, bien que UDP ne connaisse pas de connexions. C'est précisément cette table qui, lors d'une attaque distribuée, est la première ressource à s'épuiser, et elle s'épuise très vite : à 1,49 million de paquets par seconde portant chaque fois une nouvelle adresse d'expéditeur, une table de 262 144 places est remplie en moins d'un cinquième de seconde.
net.netfilter.nf_conntrack_max = 524288
net.netfilter.nf_conntrack_udp_timeout = 10
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 20
Une entrée occupe environ 300 octets, donc 524 288 entrées représentent à peu près 150 mégaoctets de mémoire noyau. La taille de la table de hachage se règle non pas par sysctl, mais comme paramètre de module, habituellement au quart de la limite supérieure, dans /etc/modprobe.d/nf_conntrack.conf :
options nf_conntrack hashsize=131072Pour un serveur purement de jeu ou de voix, la solution la plus élégante consiste à ne pas faire suivre le trafic de jeu du tout. Cela économise entièrement la table :
nft add table ip raw
nft add chain ip raw prerouting '{ type filter hook prerouting priority raw; }'
nft add rule ip raw prerouting udp dport 25565 notrack
Attention : notrack et les règles à états s'excluent mutuellement. Qui exclut un port du suivi ne doit plus utiliser de règle avec ct state pour ce port, sinon l'autorisation n'agit plus et le service est fermé.
Limitation de débit par adresse source
Une limitation de débit par adresse source est la mesure isolée la plus efficace sur le serveur, parce qu'elle frappe exactement ce que fait un attaquant et laisse passer exactement ce que fait un utilisateur. L'écart est grand : un véritable navigateur de serveurs interroge quelques fois par minute, un attaquant des centaines de fois par seconde. Avec nftables, on travaille pour cela avec des ensembles dynamiques, comme dans le jeu de règles ci-dessus ; avec iptables classique, avec hashlimit :
iptables -I INPUT -p udp --dport 27015 -m hashlimit --hashlimit-name query --hashlimit-mode srcip --hashlimit-above 10/sec --hashlimit-burst 20 -j DROP
iptables -I INPUT -p udp --dport 27015 -m length --length 0:27 -j DROP
Tous les chiffres de telles règles sont des valeurs de départ, pas des vérités. Mesurez d'abord pendant une semaine en fonctionnement normal, sinon vous éjecterez vos propres utilisateurs, et au plus mauvais moment. Notez en outre que des règles iptables seules disparaissent après un redémarrage (apt-get install -y iptables-persistent, puis netfilter-persistent save) et que, sous UFW, elles ont leur place dans /etc/ufw/before.rules, faute de quoi elles disparaîtront au prochain ufw reload. Le jeu de règles complet pour l'exploitation courante figure dans Protéger un serveur des attaques DDoS.
Où tout filtrage sur le serveur s'arrête
Vient maintenant la partie qu'aucun fichier de configuration ne résout. Toutes les mesures précédentes s'exécutent sur votre serveur, donc au bout du raccordement. Une règle de pare-feu décide du sort d'un paquet qui a déjà parcouru le câble. Vous pouvez le rejeter, mais vous ne pouvez pas faire qu'il n'ait jamais été envoyé. Si le raccordement en amont est saturé, les paquets de vos utilisateurs n'arrivent déjà plus avant cela, et ce indépendamment de la qualité de votre jeu de règles.
| Raccordement | Données utiles par seconde | Paquets par seconde pour 64 octets |
|---|---|---|
| 1 Gbit/s | 125 mégaoctets | 1 488 095 |
| 2 fois 1 Gbit/s | 250 mégaoctets | 2 976 190 |
| 10 Gbit/s | 1 250 mégaoctets | 14 880 952 |
| 25 Gbit/s | 3 125 mégaoctets | 37 202 381 |
| 100 Gbit/s | 12 500 mégaoctets | 148 809 523 |
Ce tableau répond, cas par cas, à la question de savoir si l'autoprotection suffit. L'attaque contre GitHub, avec 126,9 millions de paquets par seconde, tient tout juste en taux de paquets sur un raccordement à 100 Gbit/s, mais avec un volume de 1,35 Tbit/s il en faudrait quatorze en parallèle. L'attaque record de 31,4 Tbit/s correspond à 314 raccordements à 100 Gbit/s entièrement saturés. Un serveur de jeu est typiquement raccordé à 1 Gbit/s ou à deux fois 1 Gbit/s : la limite de l'autoprotection se situe donc autour de 1,5 à 3 millions de paquets par seconde, et en pratique nettement en dessous, parce que le noyau abandonne avant.
Il existe encore une seconde limite, plus désagréable. Dès que le raccordement est saturé, il se peut que même la session SSH avec laquelle vous vouliez mesurer ne vous parvienne plus. Qui ne dispose alors d'aucun accès indépendant du réseau, par exemple une console VNC dans l'espace client, ne peut même plus aller voir ce qui se passe.
Ce qui n'aide qu'en amont du serveur : filtrage réseau et scrubbing
Seul celui qui a plus de capacité que l'attaque peut filtrer efficacement. Cela suppose un endroit où de nombreuses lignes convergent, donc un réseau et non une machine. Là, il existe deux procédés qui se complètent.
Le filtrage en temps réel dans le réseau. L'ensemble du trafic traverse en permanence un étage de filtrage qui évalue chaque paquet avant de le transmettre au serveur. L'avantage est qu'il n'y a pas de basculement : la protection n'a pas besoin de détecter d'abord une attaque pour agir. C'est précisément ce qui compte pour les jeux, car un délai de basculement de deux minutes représente une manche perdue, et un délai de basculement de deux minutes face à une attaque qui dure 35 secondes n'est pas une défense du tout.
Le scrubbing. Lorsque le réseau détecte une grande attaque volumétrique, le trafic concerné est dérouté vers des centres de filtrage, y est débarrassé de ses parts malveillantes, puis livré en direction de la cible. Le sens de ce déroutement est la proximité : le trafic d'attaque se termine à l'endroit où il entre, au lieu de ne finir qu'au centre de données. Les règles de filtrage sont pour cela réparties dans le réseau, ce que décrit techniquement la RFC 8955 sous le nom de Flow Specification.
La contre-mesure structurelle face aux adresses d'expéditeur falsifiées est d'ailleurs connue depuis l'an 2000 et figure dans la RFC 2827, le BCP 38 : celui qui raccorde un client rejette à cette frontière tous les paquets dont l'adresse d'expéditeur n'appartient pas à ce client. La RFC 3704 étend cela aux réseaux raccordés à plusieurs opérateurs. Si tous les opérateurs de réseau appliquaient cela, toute la classe des attaques par amplification serait réglée. Elle ne l'est pas, parce qu'il suffit que quelques-uns ne le fassent pas.
Et il existe une troisième méthode qu'il faut connaître, parce qu'elle est souvent vendue comme une protection : le null-routing, techniquement Remote Triggered Black Hole Filtering selon la RFC 5635. L'adresse IP attaquée est alors annoncée comme injoignable dans le réseau, et l'ensemble du trafic qui lui est destiné est rejeté, le trafic d'attaque comme celui de vos utilisateurs. Cela protège le réseau de l'hébergeur ; pour vous, le résultat est identique à une attaque réussie, et le plus souvent pendant encore des heures. En cas de doute, demandez si le trafic est filtré ou si l'adresse est retirée du réseau. La réponse pèse davantage sur votre disponibilité que n'importe quelle fiche technique.
Ce que KernelHost oppose à cela
La protection permanente incluse dans chaque pack serveur
La protection DDoS de KernelHost repose sur deux niveaux et reste active en permanence, sans que vous ayez quoi que ce soit à activer, à commander ou à configurer :
- Niveau 1 : 17 Tbps de capacité de mitigation dans le réseau de scrubbing mondial. Les attaques volumétriques sont nettoyées au plus près de leur source, avant d'atteindre le centre de données.
- Niveau 2 : filtrage Arbor en temps réel à 3,2 Tbps à Francfort-sur-le-Main. Juste devant le serveur, les schémas propres à chaque protocole sont identifiés et rejetés, paquet par paquet.
Deux caractéristiques sont décisives. La protection fonctionne en permanence et est active dès la mise en service du serveur : il n'y a donc pas de premières minutes d'attaque pendant lesquelles le service est injoignable. Et aucun null-routing n'est utilisé : votre adresse IP reste dans le réseau, seuls les paquets malveillants sont rejetés. Quels jeux et protocoles disposent de profils de filtrage propres, cela est listé dans Protection DDoS des serveurs de jeu en temps réel.
Advanced DDoS Protection pour les projets attaqués en continu
Certains projets ne sont pas attaqués de temps à autre, mais de façon ciblée et pendant des semaines, chaque soir à la même heure et avec des schémas changeants. Pour ces cas, il existe l'Advanced DDoS Protection à partir de 50,00 € par mois, en PrePaid, sans durée minimale et sans frais de mise en service. La différence ne tient pas à une capacité supérieure, mais au contrôle :
- Une IP protégée dédiée issue du cœur de réseau de Francfort, vers laquelle votre serveur est basculé au sein de notre propre réseau. Aucune modification n'est nécessaire de votre côté.
- Des règles de protection par port et par protocole, que vous gérez vous-même dans l'espace client : vous définissez séparément ce qui est autorisé sur le port de jeu et ce qui l'est sur le port de requête, et vous pouvez ainsi exploiter précisément l'asymétrie décrite dans la section sur les protocoles de requête.
- Les changements s'appliquent en temps réel, vous pouvez donc affiner les réglages pendant une attaque en cours au lieu d'attendre une fenêtre de maintenance.
- Un profil de protection adapté au service concerné, tout comme pour les applications modifiées ou maison sur n'importe quel port TCP ou UDP.
L'Advanced DDoS Protection s'adresse aux clients de KernelHost et suppose un serveur chez KernelHost. Si votre projet tourne actuellement ailleurs et y subit régulièrement des attaques, la voie à suivre est le transfert ici, pas une prise en charge à distance de votre adresse actuelle.
Les deux niveaux comparés
| Caractéristique | Protection DDoS permanente incluse | Advanced DDoS Protection |
|---|---|---|
| Prix | comprise dans chaque pack serveur, sans supplément | à partir de 50,00 € par mois, PrePaid |
| Capacité de filtrage | 17 Tbps de scrubbing mondial, plus le filtrage Arbor en temps réel à 3,2 Tbps à Francfort-sur-le-Main | le même filtrage à deux niveaux |
| Active dès | la mise en service du serveur | la mise en service de l'IP protégée |
| Adresse IP | l'adresse IP de votre serveur | IP protégée dédiée supplémentaire |
| Jeu de règles | profils automatiques, aucune configuration nécessaire | vos propres règles par port et par protocole dans l'espace client |
| Modifications | suivent automatiquement | s'appliquent en temps réel, y compris pendant une attaque |
| Null-routing | non | non |
| Durée d'engagement | liée au pack serveur | PrePaid, sans durée minimale, sans préavis de résiliation, sans frais de mise en service |
Six attaques réellement filtrées en exploitation
Les six attaques suivantes ont touché des serveurs de clients de KernelHost et ont été entièrement filtrées en temps réel, chaque fois sans indisponibilité. Les illustrations proviennent de la supervision en direct de la défense.
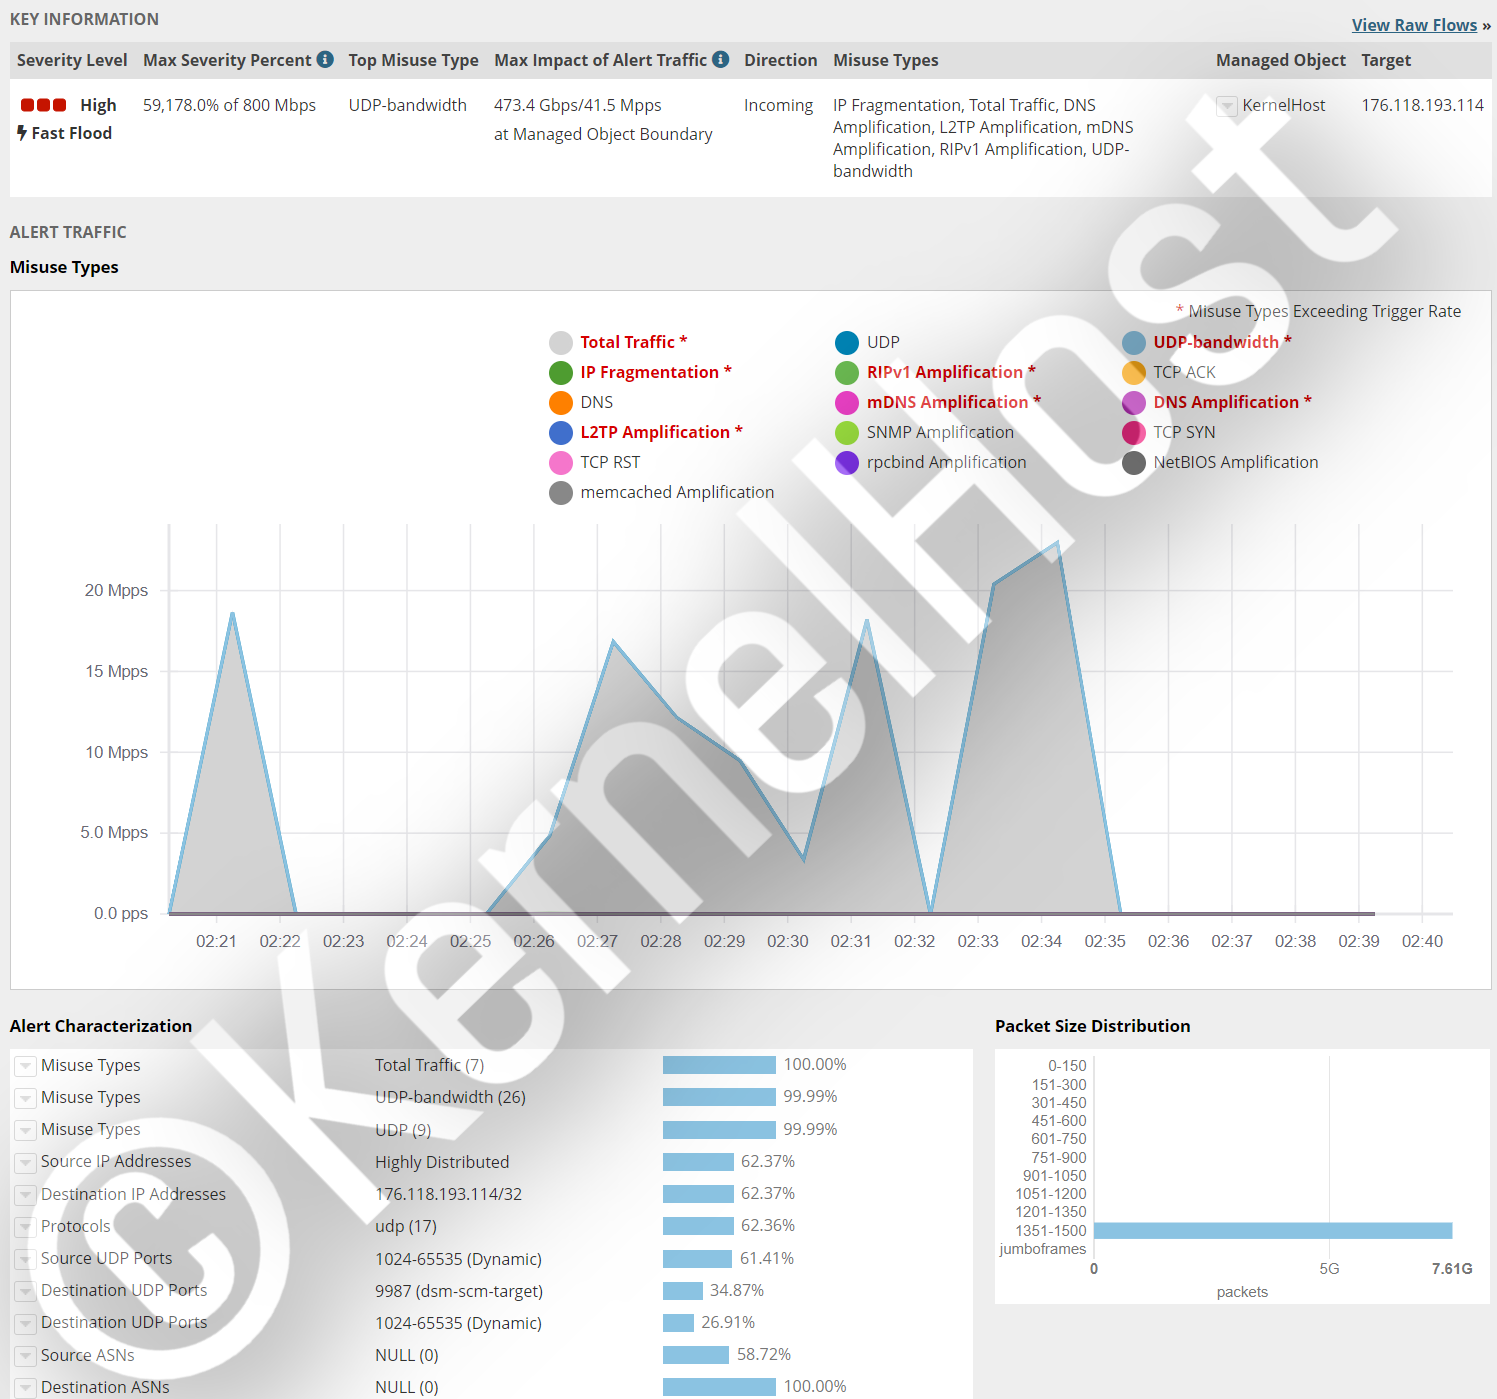
Serveur vocal TeamSpeak 3, port 9987 UDP. Attaque complexe avec plusieurs schémas simultanés, plus de 473,4 Gbit/s et plus de 41,5 millions de paquets par seconde. C'est environ 28 fois le taux de paquets d'un raccordement à 1 Gbit/s.
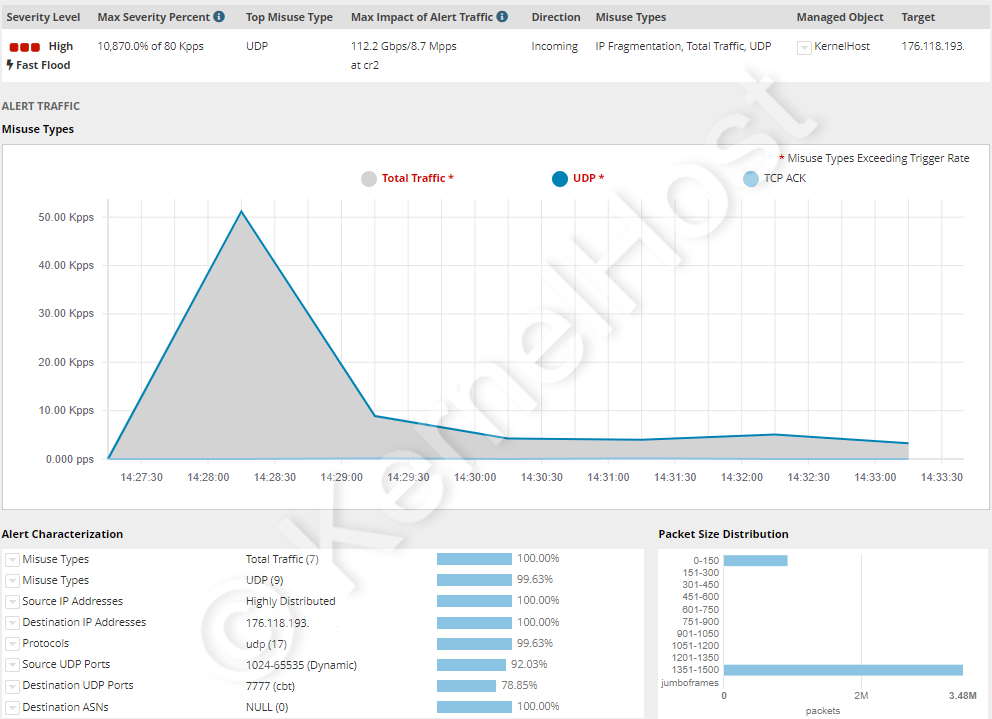
Serveur de jeu ARK, port 7777 UDP. Flood UDP simple, sans structure complexe, mais avec plus de 112,2 Gbit/s et plus de 8,7 millions de paquets par seconde. Comment sécuriser un cluster ARK par ses propres moyens, cela figure dans Protéger un serveur ARK des attaques DDoS.
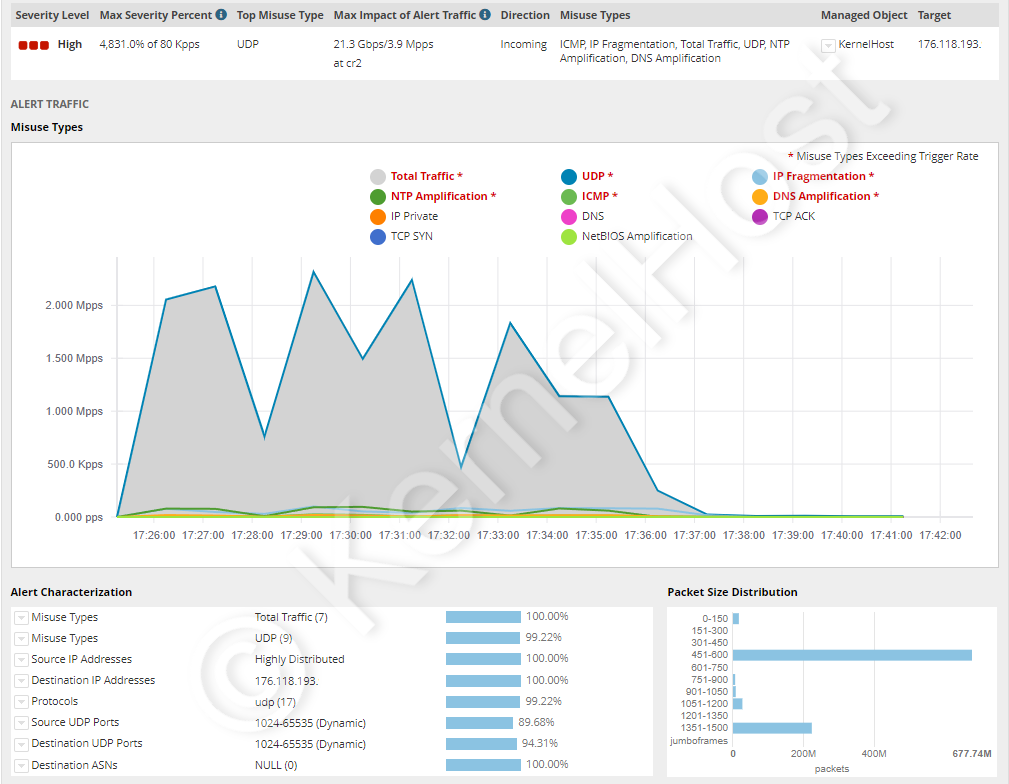
Attaque sur tous les ports, ports 0-65535 TCP et UDP. Plus de douze schémas d'attaque principaux différents contre l'intégralité des ports en même temps, au total plus de 21,3 Gbit/s et plus de 3,9 millions de paquets par seconde. Ce cas montre la dispersion sur tous les ports que présente aussi le cas Cloudflare de mai 2025, avec 21 925 ports cibles en moyenne.
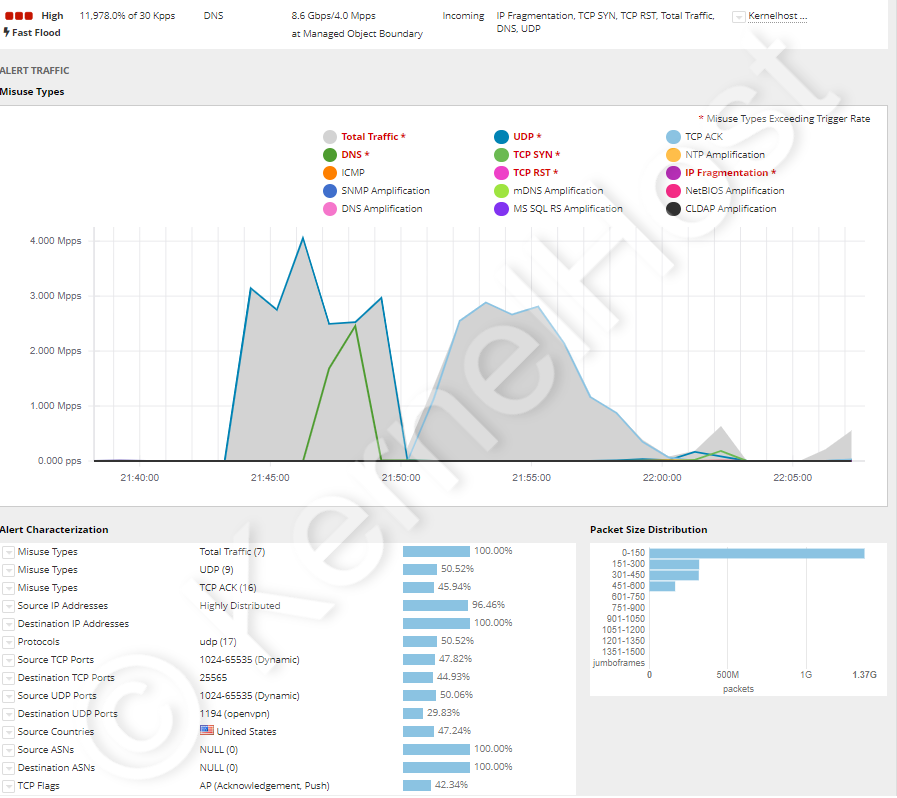
Minecraft et OpenVPN, ports 25565 TCP et 1194 UDP. Attaque combinée avec plus de seize schémas d'attaque principaux différents, plus de 4 millions de paquets par seconde et plus de 8,6 Gbit/s. Les deux services sont restés joignables en continu, bien qu'ils parlent des protocoles différents.
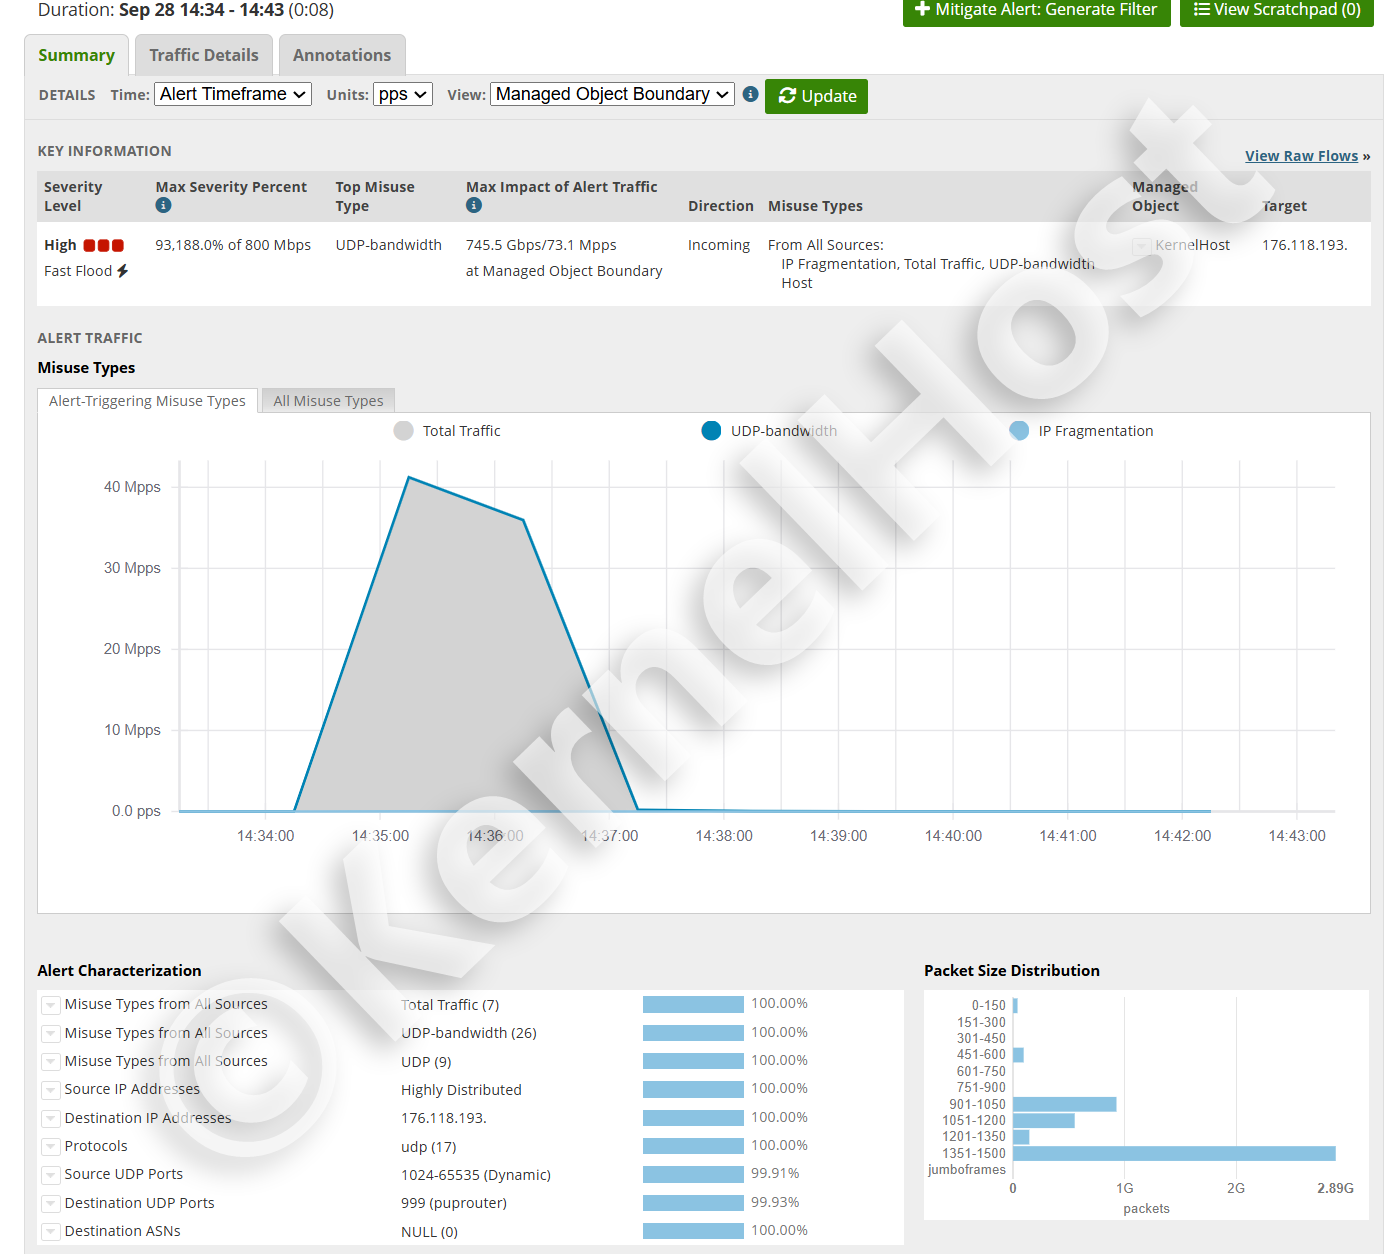
Flood UDP sur un seul port de service, huit minutes. Le plus violent des six cas : 745,5 Gbit/s et 73,1 millions de paquets par seconde, soit environ 49 fois le taux de paquets d'un raccordement à 1 Gbit/s. 99,93 pour cent du trafic visaient un seul port cible, les sources étaient entièrement réparties. Au bout de huit minutes, l'attaque était terminée, le service est resté joignable en continu.
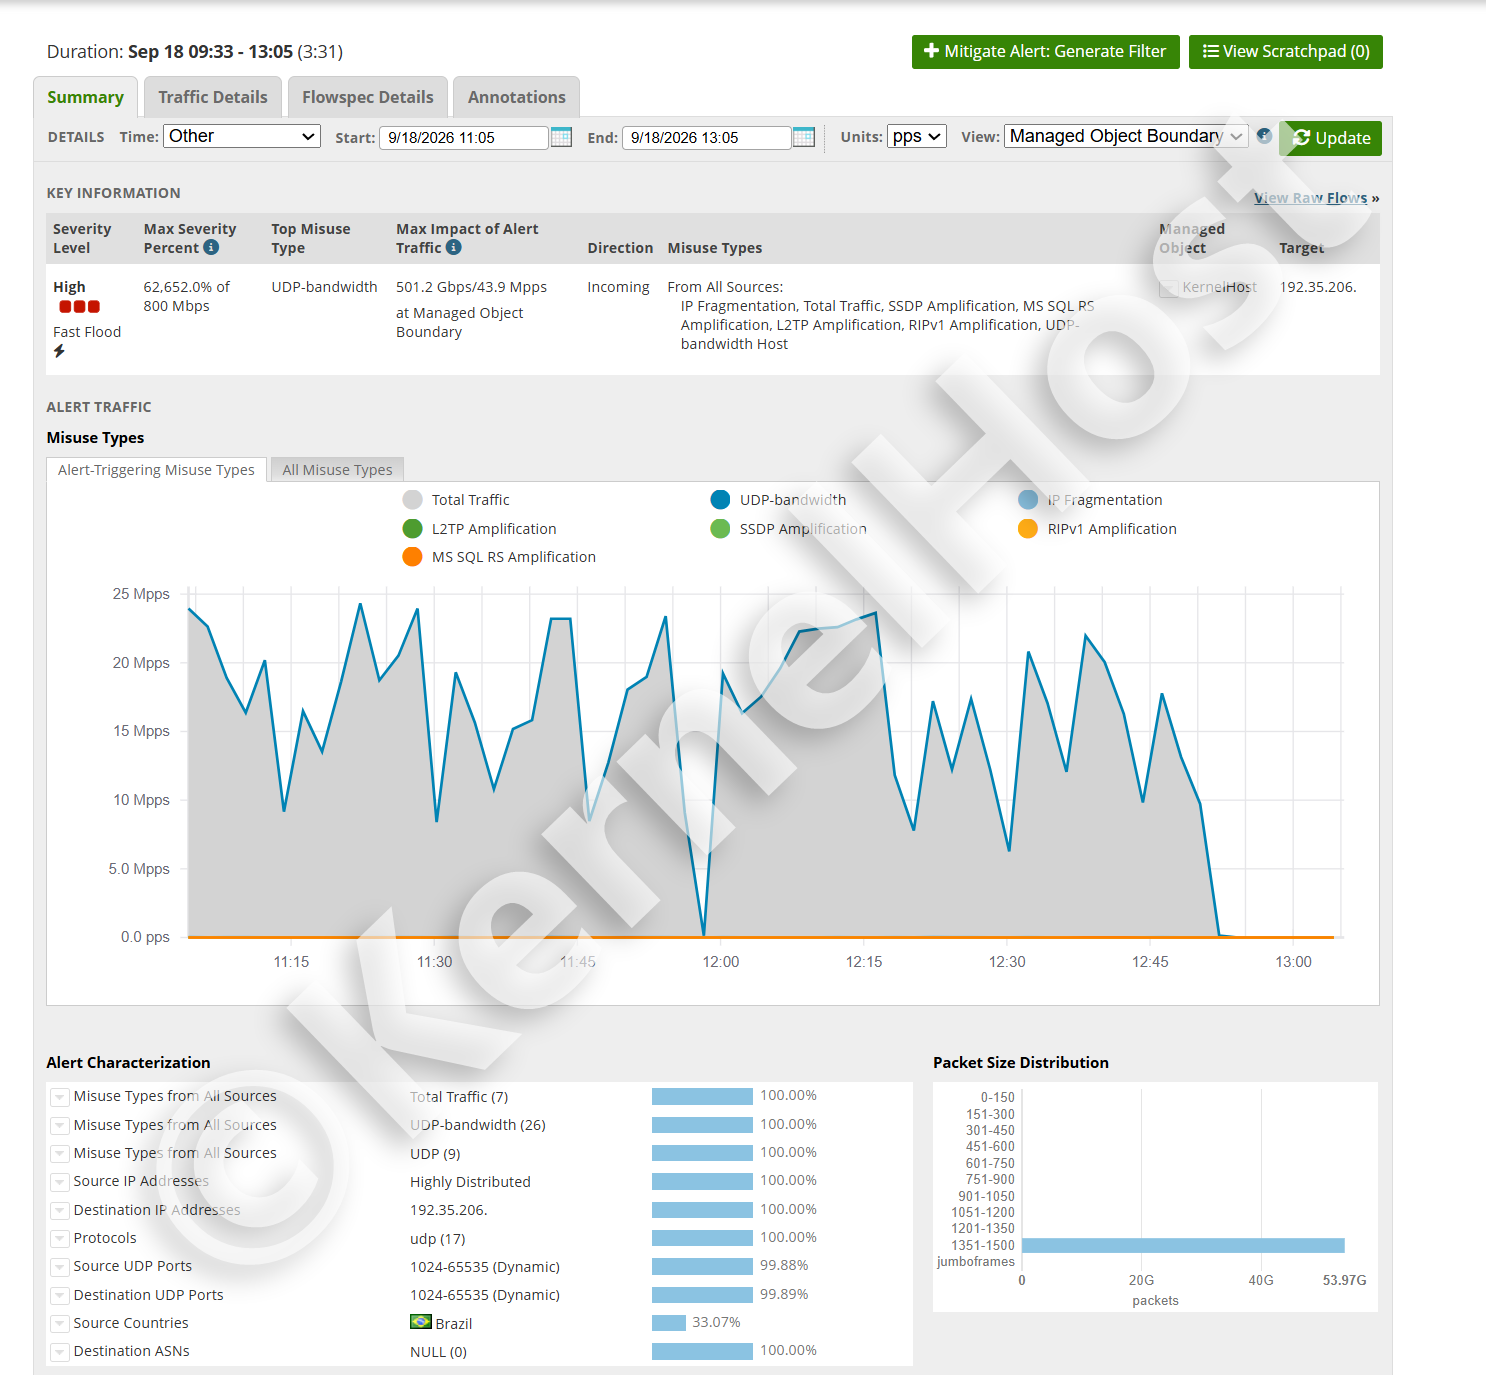
Attaque continue de trois heures et 31 minutes. 501,2 Gbit/s et 43,9 millions de paquets par seconde, non pas comme un pic isolé, mais comme une suite de vagues sans interruption. Sept schémas d'attaque simultanés, dont des amplifications via SSDP, MS SQL RS, L2TP et RIPv1. Les ports cibles se répartissaient sur l'intégralité de la plage de 1024 à 65535, changer de port n'aurait donc rien apporté. Plus de détails sur ces deux cas dans Combien de temps dure une attaque DDoS.
Ce qu'il faut faire en cas d'attaque, dans cet ordre
L'ordre importe plus que les étapes prises séparément, parce que les erreurs les plus fréquentes se produisent dans les cinq premières minutes.
- Mesurer, pas bricoler. Sauvegardez d'abord dans un fichier les valeurs de
sar -n DEV 1 10,ip -s link show,ss -setdmesg -T. Après l'attaque, elles auront disparu, et sans elles personne ne peut vous aider. - Ne pas redémarrer. Un redémarrage efface tous les compteurs, tous les états de connexion et toutes les preuves, et la charge est de retour au bout de quelques secondes.
- Déterminer de quel niveau il s'agit. Les octets divisés par les paquets donnent la taille moyenne des paquets. En dessous de 100 octets, cela indique une attaque protocolaire ; au-dessus de 1 000 octets, une attaque par amplification ; des tailles normales avec une charge CPU élevée, la couche 7.
- Fermer les ports d'administration. Panel, base de données, RCON et tout ce qui n'a pas besoin d'être public doit être restreint à votre propre adresse. Cela réduit immédiatement la surface d'attaque, et sans risque pour les utilisateurs.
- Poser une limitation de débit, serrée sur le port de requête, large sur le port d'usage. Ne bloquez pas le port de requête, sinon vous disparaîtrez de chaque liste de serveurs.
- Ne pas changer d'adresse trop vite. Un changement d'adresse n'agit que tant que la nouvelle adresse n'est pas de nouveau publique, et un ancien enregistrement DNS oublié rend le changement inopérant.
- Impliquer l'hébergeur avec des chiffres. Ouvrez un ticket avec l'horaire, le port cible, le taux de paquets, la bande passante et la taille moyenne des paquets. Ces cinq indications décident de la vitesse à laquelle les règles de filtrage seront ajustées pour votre adresse.
- Documenter ensuite. Notez quand cela a commencé, combien de temps cela a duré et quel schéma était en cause. Des attaques récurrentes à la même heure sont le critère qui indique si un projet a besoin d'une IP protégée dédiée.
La procédure détaillée pour une attaque lourde et de longue durée figure dans Attaque DDoS lourde : que faire.
Situation juridique : une attaque DDoS est une infraction pénale
En Autriche, une attaque DDoS relève du § 126b du code pénal autrichien (StGB), « Störung der Funktionsfähigkeit eines Computersystems », soit l'atteinte au fonctionnement d'un système informatique. L'infraction de base prévoit une peine privative de liberté pouvant aller jusqu'à six mois ou une amende pouvant atteindre 360 jours-amende. Si le trouble dure un temps prolongé, la peine va jusqu'à deux ans. Si de nombreux systèmes sont attaqués avec un programme manifestement créé à cette fin, elle va jusqu'à trois ans. Et en cas de dommage supérieur à 300 000 euros, d'attaque contre une infrastructure critique ou d'agissement en tant que membre d'une association criminelle, la fourchette est de six mois à cinq ans. En complément, le § 126c StGB sanctionne déjà la fabrication, la diffusion et la mise à disposition des programmes destinés à cet usage.
En Allemagne, c'est le § 303b du code pénal allemand (StGB) qui s'applique, « Computersabotage », soit le sabotage informatique : jusqu'à trois ans de peine privative de liberté ou une amende, jusqu'à cinq ans lorsque le traitement de données sert un établissement, une entreprise ou une autorité, et dans les cas particulièrement graves de six mois à dix ans, par exemple en cas d'agissement à titre professionnel ou d'atteinte à une infrastructure critique. La tentative est punissable, et pour les actes préparatoires le § 303b al. 5 StGB renvoie au § 202c StGB.
Les services de booter et de stresser ne sont donc pas une zone grise, mais la partie payante d'une infraction pénale. Trois points sont régulièrement mal compris. Premièrement, la mention « uniquement pour des tests de charge sur vos propres systèmes » ne rend rien légal, parce que ces services ne vérifient pas à qui appartient la cible inscrite. Deuxièmement, le donneur d'ordre est punissable aussi, pas seulement l'exploitant : après la semaine d'action d'avril 2026, Europol a expressément écrit à plus de 75 000 utilisateurs identifiés pour clarifier exactement ce point. Troisièmement, un test de charge contre votre propre serveur via un tel service n'est pas une solution non plus, parce que le trafic d'attaque passe par le réseau de l'hébergeur et donc par les lignes d'autres clients, ce que tout contrat d'hébergement interdit. Qui veut vraiment mesurer la résistance de son service le fait en l'annonçant et en accord avec son hébergeur. Cette section restitue l'état du droit et ne constitue pas un conseil juridique.
Le guide adapté à votre service
Cet article explique le principe. Quel port doit rester ouvert, quelle directive de configuration limite quelle requête, et où se situe la limite pour chaque jeu : cela figure dans les articles consacrés à chaque service, chacun avec son tableau de faits des ports.
- Bases et procédure : Détecter une attaque DDoS, Protéger un serveur des attaques DDoS, Attaque DDoS lourde : que faire, Protection DDoS des jeux avec filtrage en temps réel
- Minecraft et voix : Minecraft et Nullping, Minecraft Bedrock, TeamSpeak 3, Hytale
- Jeu de rôle sur base GTA : FiveM, RedM, RAGE MP et alt:V, SA-MP et open.mp, MTA:SA
- Survie et construction : Rust, ARK, DayZ, Palworld, Conan Exiles, Project Zomboid, Terraria, Unturned
- Tactique et tir : CS2 et Source, Arma 3, Call of Duty, Team Fortress 2, Left 4 Dead 2, Garry's Mod, Mordhau, Lineage 2
En résumé
- Une attaque DDoS occupe l'une de quatre ressources finies : la bande passante, le taux de paquets, une table d'états du noyau ou le temps de calcul de l'application. Elle n'exploite aucune faille de sécurité, c'est pourquoi les mises à jour seules ne protègent pas.
- La RFC 4732 définit une attaque DoS par son effet, non par le nombre de sources. Elle est dite distribuée lorsque les sources sont nombreuses : dans le cas Cloudflare de mai 2025, il s'agissait de 122 145 adresses réparties sur 161 pays.
- La CISA, le FBI et le MS-ISAC distinguent trois techniques : volumétrique en Gbit/s, protocolaire en paquets par seconde, applicative en requêtes par seconde. Chacune exige une défense différente.
- Les attaques par amplification détournent des services UDP ouverts. Les facteurs vont de 5,5 pour le protocole Steam à 30,8 pour SSDP et 556,9 pour NTP, jusqu'à 51 000 pour memcached, comme indiqué dans l'alerte US-CERT TA14-017A.
- La capacité provient de botnets d'appareils détournés, de 600 000 pour Mirai en 2016 jusqu'à un à quatre millions estimés derrière l'attaque record de 31,4 Tbit/s, et elle est revendue à partir d'environ 10 euros par mois.
- Sur le serveur,
nftables, les SYN cookies, des limites conntrack ajustées et une limitation de débit par adresse source agissent. Elles s'arrêtent autour de 1,5 million de paquets par seconde, parce qu'un raccordement à 1 Gbit/s n'en transporte pas davantage. - Au-delà de cette limite, seul le filtrage dans le réseau, en amont du serveur, est déterminant. Le null-routing n'est pas une défense, c'est le résultat que l'attaquant voulait.
- Chez KernelHost, la protection permanente à deux niveaux est comprise dans chaque pack serveur sans supplément et active dès la mise en service, sans null-routing : 17 Tbps de capacité de mitigation dans le réseau de scrubbing mondial, plus un filtrage Arbor en temps réel à 3,2 Tbps à Francfort-sur-le-Main. L'Advanced DDoS Protection la complète à partir de 50,00 € par mois par une IP protégée dédiée et des règles par port que vous gérez vous-même.
- Une attaque DDoS est punissable en Autriche selon le § 126b StGB et en Allemagne selon le § 303b StGB, pour le donneur d'ordre comme pour l'exploitant des services.
Si votre projet est déjà hébergé chez KernelHost, le filtrage est actif sans que vous ayez quoi que ce soit à faire. Si vous constatez malgré tout des anomalies, ouvrez un ticket de support avec les cinq indications de l'étape 7, afin que les règles de filtrage soient ajustées pour votre adresse IP. Pendant une attaque en cours, vous pouvez également nous joindre via le chat d'urgence WhatsApp au +43 650 8209883.
Questions fréquentes
Qu'est-ce qu'une attaque DDoS ?
Quelle est la différence entre DoS et DDoS ?
Quels types d'attaques DDoS existe-t-il ?
Qu'est-ce qu'une attaque par amplification et quels sont les facteurs d'amplification ?
D'où vient la capacité pour une attaque DDoS et combien coûte une attaque ?
Comment savoir si mon serveur est en train d'être attaqué ?
Quelles lignes de journal prouvent une attaque DDoS ?
Un pare-feu sur le serveur suffit-il contre les attaques DDoS ?
Quels réglages sur le serveur aident vraiment contre le DDoS ?
Pourquoi ne devrais-je pas simplement bloquer le port de requête ?
Qu'est-ce que le null-routing et pourquoi n'est-ce pas une défense ?
Que faire en premier si mon serveur est actuellement attaqué ?
Mon serveur chez KernelHost est-il coupé pendant une attaque ?
Combien coûte la protection DDoS chez KernelHost et quand ai-je besoin de l'Advanced DDoS Protection ?
Une attaque DDoS est-elle punissable ?
2023-2026 KernelHost GmbH. Tous droits réservés. Ce guide est protégé par le droit d'auteur. Sa republication sur d'autres sites web, même partielle ou sous une forme modifiée, n'est pas autorisée sans notre accord écrit. Les citations accompagnées de la source et d'un lien sont expressément les bienvenues.



